Harness VLA: Steering Frozen VLAs into Reliable Manipulation Primitives via Memory-Guided Agents
摘要
语言条件操控需要精确的接触丰富控制与对语言、场景和长程任务的鲁棒推理。端到端VLA模型提供强大的局部视觉运动技能,但在部署扰动下往往性能下降。本文提出 Harness VLA,一种记忆增强的智能体框架,将冻结的VLA暴露为可重试的接触丰富原语,并与少量固定分析原语库组合。该框架无需微调即可将预训练VLA扩展到原始轨迹分布之外。在LIBERO-Pro和RoboCasa365上分别比最强基线提升38.6和25.4个百分点,在RoboTwin C2R上达到58.4%。
技术细节
冻结VLA + 分析原语组合
论文解读
用记忆引导智能体框架,让冻结VLA在扰动环境下可靠操控
语言条件操控需要精确的接触丰富控制与对语言、场景和长程任务的鲁棒推理。端到端VLA模型提供强大的局部视觉运动技能,但在部署扰动下(如语义重定向、目标重绑定、空间布局偏移和不稳定局部接触)往往性能下降。本文提出 Harness VLA,一种记忆增强的智能体框架,将冻结的VLA暴露为可重试的接触丰富原语,并与少量固定分析原语库组合,用于定位、暂存、运输、导航和释放。该框架无需微调即可将预训练VLA扩展到原始轨迹分布之外。在LIBERO-Pro和RoboCasa365上分别比最强基线提升38.6和25.4个百分点,在RoboTwin C2R上达到58.4%。
核心问题:VLA模型的部署困境
机器人操控领域长期追求一个目标:构建能够可靠执行自由形式自然语言指令的系统,适应不断变化的物体、布局和机器人本体。当前两大主流范式从相反方向逼近这一目标:
端到端VLA模型(如π₀、OpenVLA、RT-2)直接从机器人轨迹学习接触丰富的视觉运动控制。它们的优势在于局部、图像条件的接触任务——抓取不规则物体、精确放置、操作易碎的夹具。然而,这些模型的根本弱点在于部署时超出训练分布。一个在分布内任务轨迹上训练的模型可能知道如何抓取牛奶盒或转动水龙头,但当语义目标被重定向、目标谓词被重新绑定、物体布局发生偏移,或者短技能需要组合成长程例行程序时,策略可能会重复熟悉的训练时行为,即使指令或场景绑定已经改变。一次不稳定的接触失败就可能破坏整个单体化展开。
LLM编码智能体(如Code-as-Policy、SayCan)提供互补的语义推理和组合规划能力。它们通过语言模型推理来组合显式的感知和控制API。然而,这些智能体必须通过手工设计或智能体生成的API来实现物理上精细的交互,在处理不规则抓取、约束放置和关节物体交互时力不从心。
这两种范式各自强大,但各自将错误的组件赋予了过多责任:单体化VLA必须在单一策略内吸收语言接地、长程组合和低级控制;而编码智能体必须通过手工设计的API实现物理精细交互。Harness VLA的核心洞察是:使用分析原语穿越部署扰动,仅在局部接触丰富区域调用VLA,在这些区域其训练分布具有信息量。这种设计让VLA专注于其擅长的局部接触控制,而将语义重定位、非接触执行和VLA重暂存交给规划层。
具体而言,部署扰动包括四种主要类型:(1)语义重定向——任务目标从训练时的物体转移到新物体;(2)目标重绑定——任务谓词与不同物体重新关联;(3)空间布局偏移——物体位置相对于训练分布发生显著变化;(4)不稳定局部接触——抓取失败、滑动、碰撞等接触异常。现有VLA模型在这些扰动下往往完全失败,而Harness VLA通过原语组合和记忆增强机制实现了鲁棒的任务完成。
方法解剖:Harness VLA 框架

图1:Harness VLA 系统概览。智能体规划器从固定原语库中选择结构化调用,而非直接输出低级动作。冻结VLA作为 vla_act 处理接触丰富行为,分析原语(move_to、rotate、set_gripper)负责感知条件的暂存、运输、姿态调整和释放。
图1展示了Harness VLA的核心设计理念。左侧是任务描述、RGB-D观测和机器人状态作为输入,中间是智能体规划器(Agentic Planner),它从固定原语库(Primitive Library)中选择结构化调用。右侧展示了原语的执行流程:分析原语(如move_to、rotate、set_gripper)处理非接触或简单接触任务,而vla_act原语调用冻结的VLA处理接触丰富的精细操控。这种设计的关键创新在于将VLA限制在其擅长的局部接触区域,而将语义重定位、空间导航和姿态调整交给确定性原语。规划器通过JSON序列化的原语接口与环境交互,每个原语执行直到其内部后条件满足,然后返回新的观测和机器人状态。这种轮次制的执行循环让规划器能够专注于组合推理,而不必处理低级控制细节。
Harness VLA 的核心思想是将VLA限制在其擅长的局部接触区域,而将语义重定位、非接触执行和VLA重暂存交给规划层。框架包含三个关键组件:
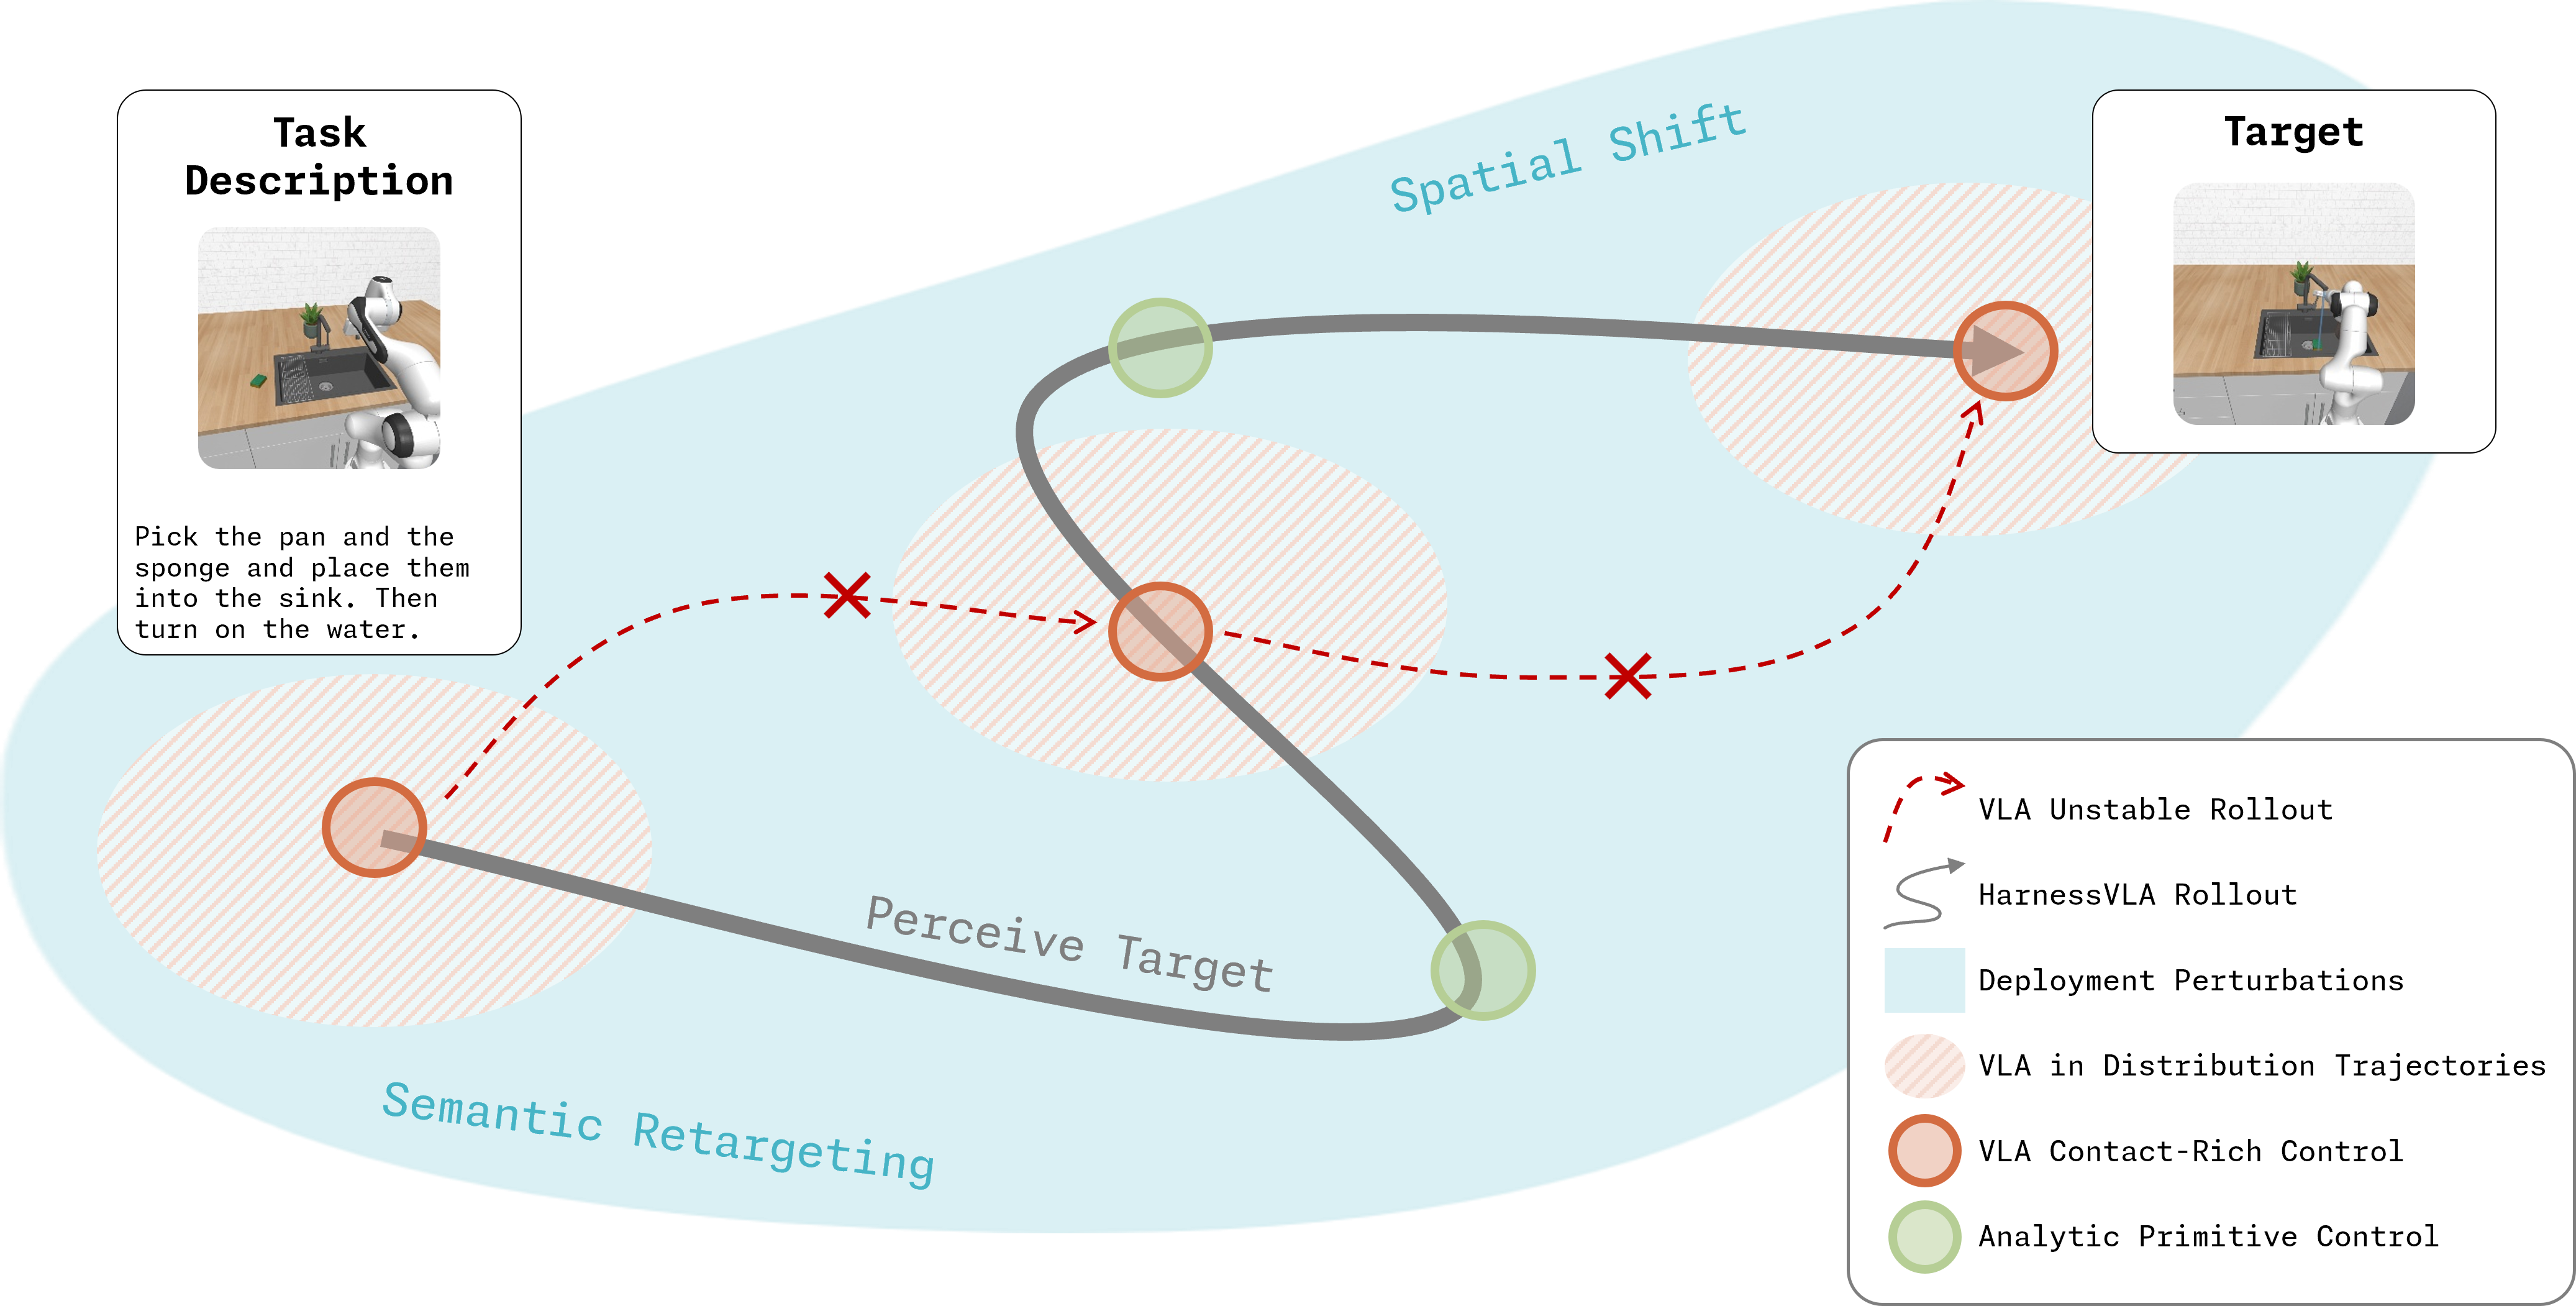
图2:原语组合将冻结VLA扩展到轨迹分布之外。通过解析原语处理部署扰动,仅在局部接触丰富区域调用VLA。
图2直观展示了Harness VLA如何将冻结VLA扩展到原始轨迹分布之外。上半部分展示了标准VLA的行为:当面临部署扰动(如目标物体改变、位置偏移)时,VLA倾向于重复训练时的行为模式,导致失败。下半部分展示了Harness VLA的行为:通过解析原语(如move_to定位到正确位置、rotate调整姿态)处理部署扰动,仅在局部接触丰富区域(如抓取、放置)调用VLA。这种"先定位后操控"的策略让系统能够在训练分布之外的场景中可靠工作。图中用不同颜色标注了分析原语(蓝色)和VLA调用(绿色)的分布,清晰展示了两者如何协同工作。关键洞察是:VLA不需要处理所有情况,只需要在其训练分布有信息量的局部接触区域发挥作用。
固定原语库:包含 move_to(复合)、move_pose(复合)、rotate_wrist(原子)、rotate_pitch(原子)、set_gripper(原子)、release(原子)和 vla_act(VLA调用)。这些原语覆盖了从感知定位到接触操控的完整流程。原语库是固定的,规划器不能在部署时引入新原语,这确保了系统的可控性和可解释性。
任务特定记忆(Task Specific Memory):存储来自参考种子探索的成功命令轨迹,用于少样本重定位。在探索引导阶段,智能体在单个参考任务实例上自主交互,发现工作解决方案。规划器被唯一授予访问重置原语的权限,并在宽松的时间预算下操作。探索聚焦于迭代组合:发现学习的VLA原语和确定性分析原语的优化编排。规划器反复试验不同的暂存顺序、接触前姿态、vla_act调用时机和早停终止阈值。它观察物理结果,记录哪些原语序列成功,哪些失败,并将成功的原始轨迹存储到任务特定记忆中。当面临新种子或扰动时,系统可以从历史成功轨迹中检索相似场景的解决方案,并将所有空间参数从当前观测中重新接地。
全局记忆(Global Memory):存储可复用的成功规则和失败模型。这些跨任务的通用知识帮助系统快速判断何时应该调用VLA、何时应该使用分析原语。全局记忆从多个任务的探索中提取泛化的启发式规则,例如"当目标物体在视野边缘时,先使用move_to将其移到中心再调用vla_act"。这种记忆机制让系统能够跨任务迁移知识,加速新任务的适应。
智能体执行循环:任务展开被形式化为高级智能体规划器Π与底层物理引擎之间的自回归、轮次制交互。在每个执行轮次t,规划器Π处理当前多模态观测o_t、任务描述ℓ以及从任务特定记忆和全局记忆中检索的上下文。作为唯一的认知编排器,Π发出选中原语c_t∈𝒫的结构化JSON调用。物理引擎直接接收此调用并在模拟器中执行相应的物理动作,直到原语的内部后条件满足。原语终止后,引擎产生后续观测o_{t+1}和更新的机器人状态q_{t+1}。这种环境-规划器循环持续迭代,直到目标谓词𝒢满足或最大步数预算耗尽。
探索引导阶段与部署评估阶段:系统将智能体生命周期分为两个不同阶段。探索引导阶段在单个参考任务实例上操作,智能体自主发现工作解决方案,规划器被授予访问重置原语的权限,并在宽松时间预算下操作。探索聚焦于迭代组合:发现VLA原语和分析原语的优化编排。部署评估阶段则严格测试泛化能力,系统不能使用任务特定记忆或全局记忆进行目标设置,测试在线规划器推理和冻结原语接口的迁移能力。
自适应VLA调用机制
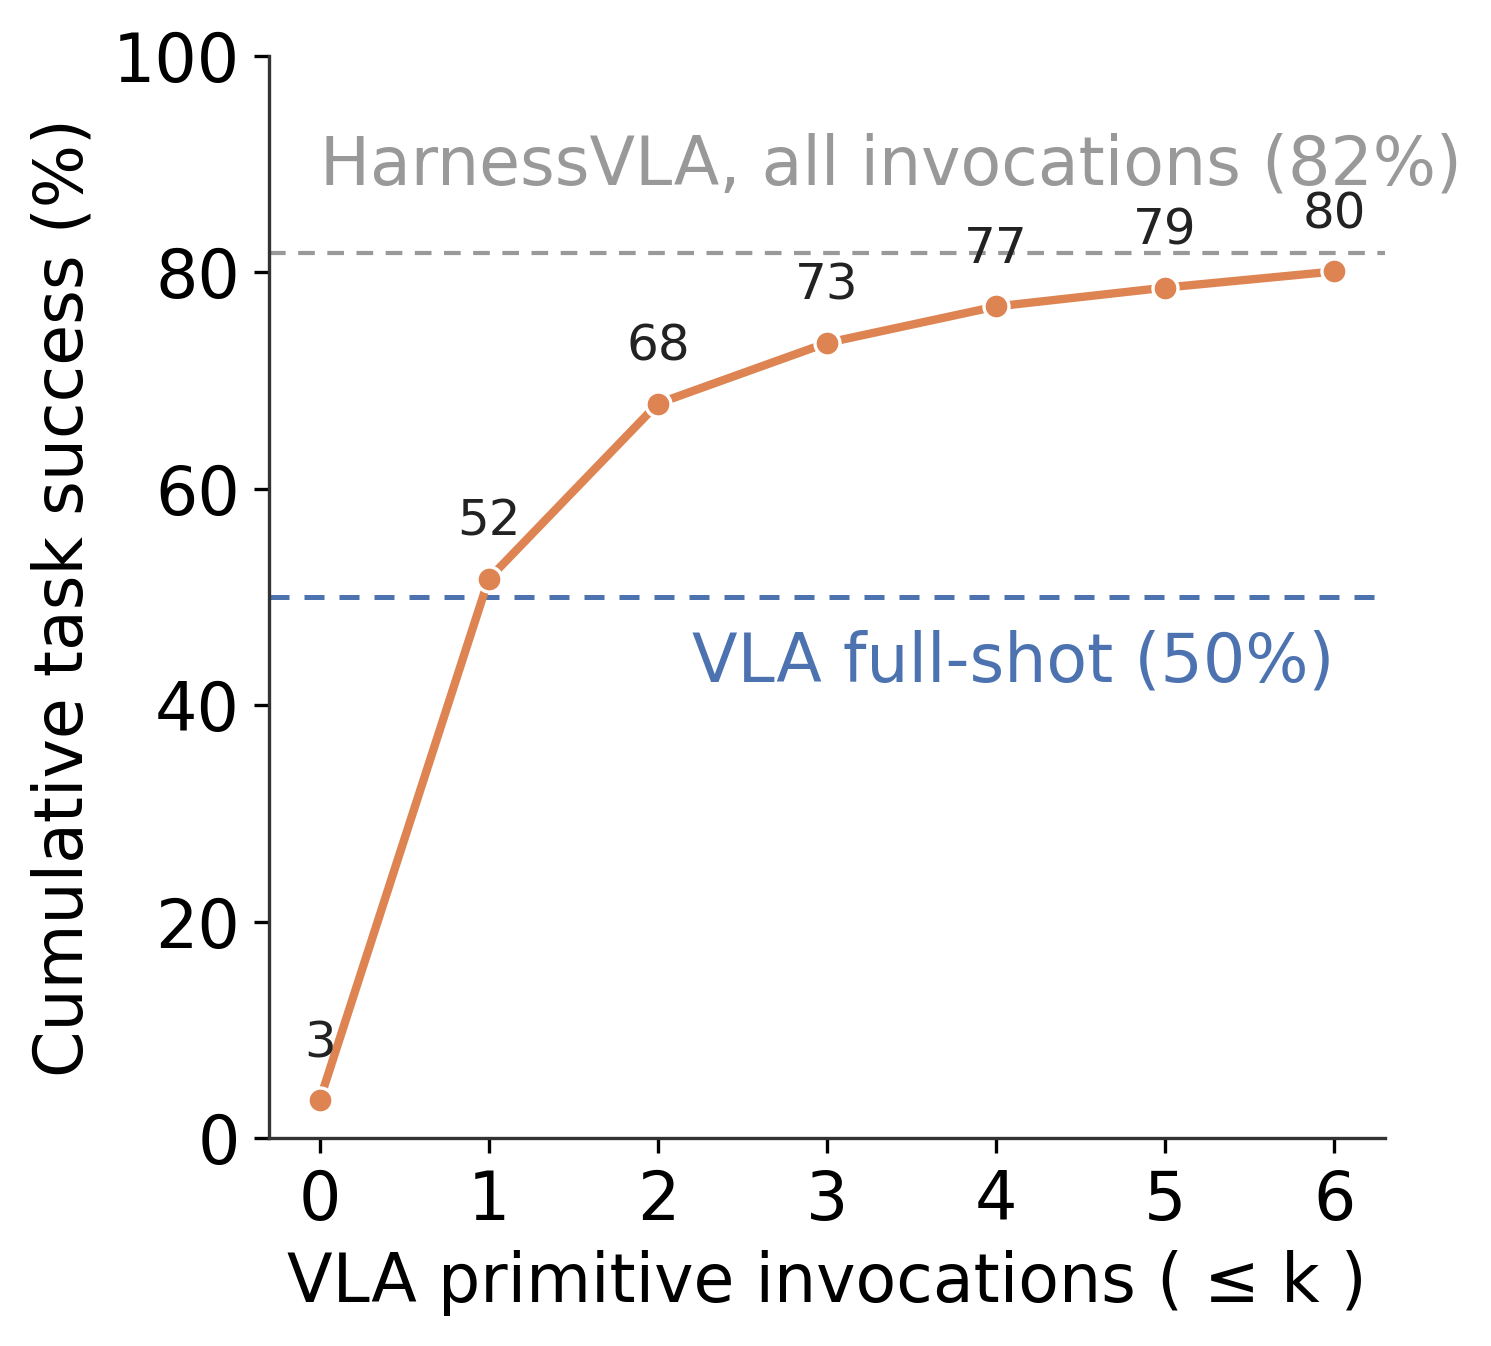
图5:自适应VLA调用分析。(a) LIBERO-Pro上不同方法的VLA调用成功率;(b) RoboCasa365上的对比;(c) RoboTwin C2R上的对比。Harness VLA通过选择性调用显著提升了VLA的有效利用率。
图5展示了自适应VLA调用机制的效果。三个子图分别对应三个基准测试:(a) LIBERO-Pro扰动测试,(b) RoboCasa365家庭场景,(c) RoboTwin C2R双臂操控。每个子图对比了不同方法的VLA调用成功率。关键发现是:Harness VLA的VLA调用成功率显著高于直接调用冻结VLA的基线方法。这是因为Harness VLA通过智能判断何时调用VLA、何时使用分析原语,最大化了VLA的有效利用率。当目标明确、接触简单时,系统使用分析原语快速完成;当面临不规则抓取、约束放置等复杂接触时,才激活VLA。这种选择性调用策略让冻结VLA在其训练分布有信息量的区域发挥作用,避免了在分布外场景中的盲目调用。图中还展示了不同规划器(Codex vs Claude Code)的调用模式差异,揭示了规划器推理能力对VLA利用率的影响。
关键创新在于自适应VLA调用策略:系统不是盲目调用VLA,而是根据当前场景判断是否需要接触丰富的精细控制。当目标明确、接触简单时,使用分析原语快速完成;当面临不规则抓取、约束放置等复杂接触时,才激活VLA。这种策略的核心在于原语的后条件设计:每个原语都有明确的完成条件,规划器可以根据观测判断原语是否成功,从而决定下一步调用哪个原语。
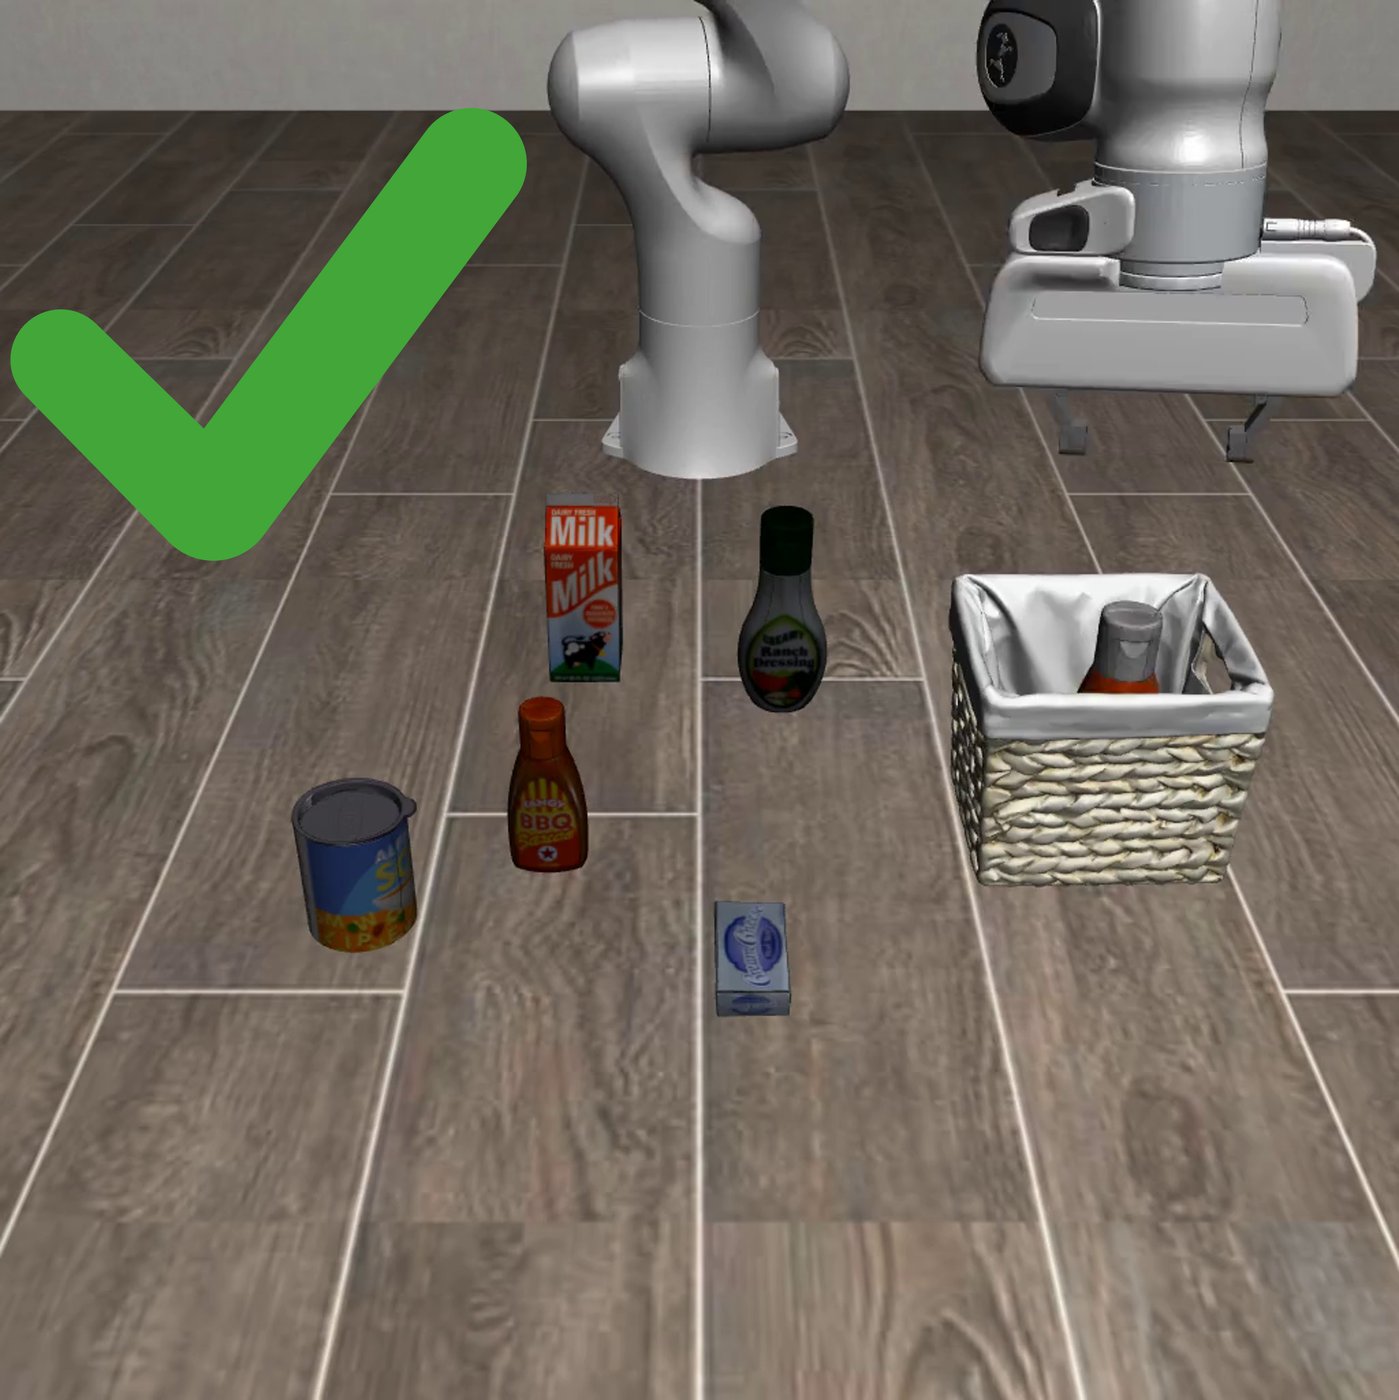
图3展示了LIBERO-Pro扰动测试中不同方法的终端状态对比。第一行是标准VLA(如π₀)在物体扰动下的表现:当目标物体位置发生偏移时,VLA倾向于重复训练时的行为模式,导致抓取失败或放置到错误位置。第二行是π₀扰动版本的表现:同样面临部署扰动,性能显著下降。第三行是Harness VLA的表现:通过move_to原语先定位到正确位置,然后调用vla_act进行精确抓取,成功完成任务。图中用红色箭头标注了失败案例,绿色箭头标注了成功案例。关键观察是:标准VLA在分布外场景中表现出"行为惯性"——即使指令或场景绑定已经改变,仍然重复训练时的行为;而Harness VLA通过解析原语处理部署扰动,仅在局部接触丰富区域调用VLA,实现了可靠的任务完成。
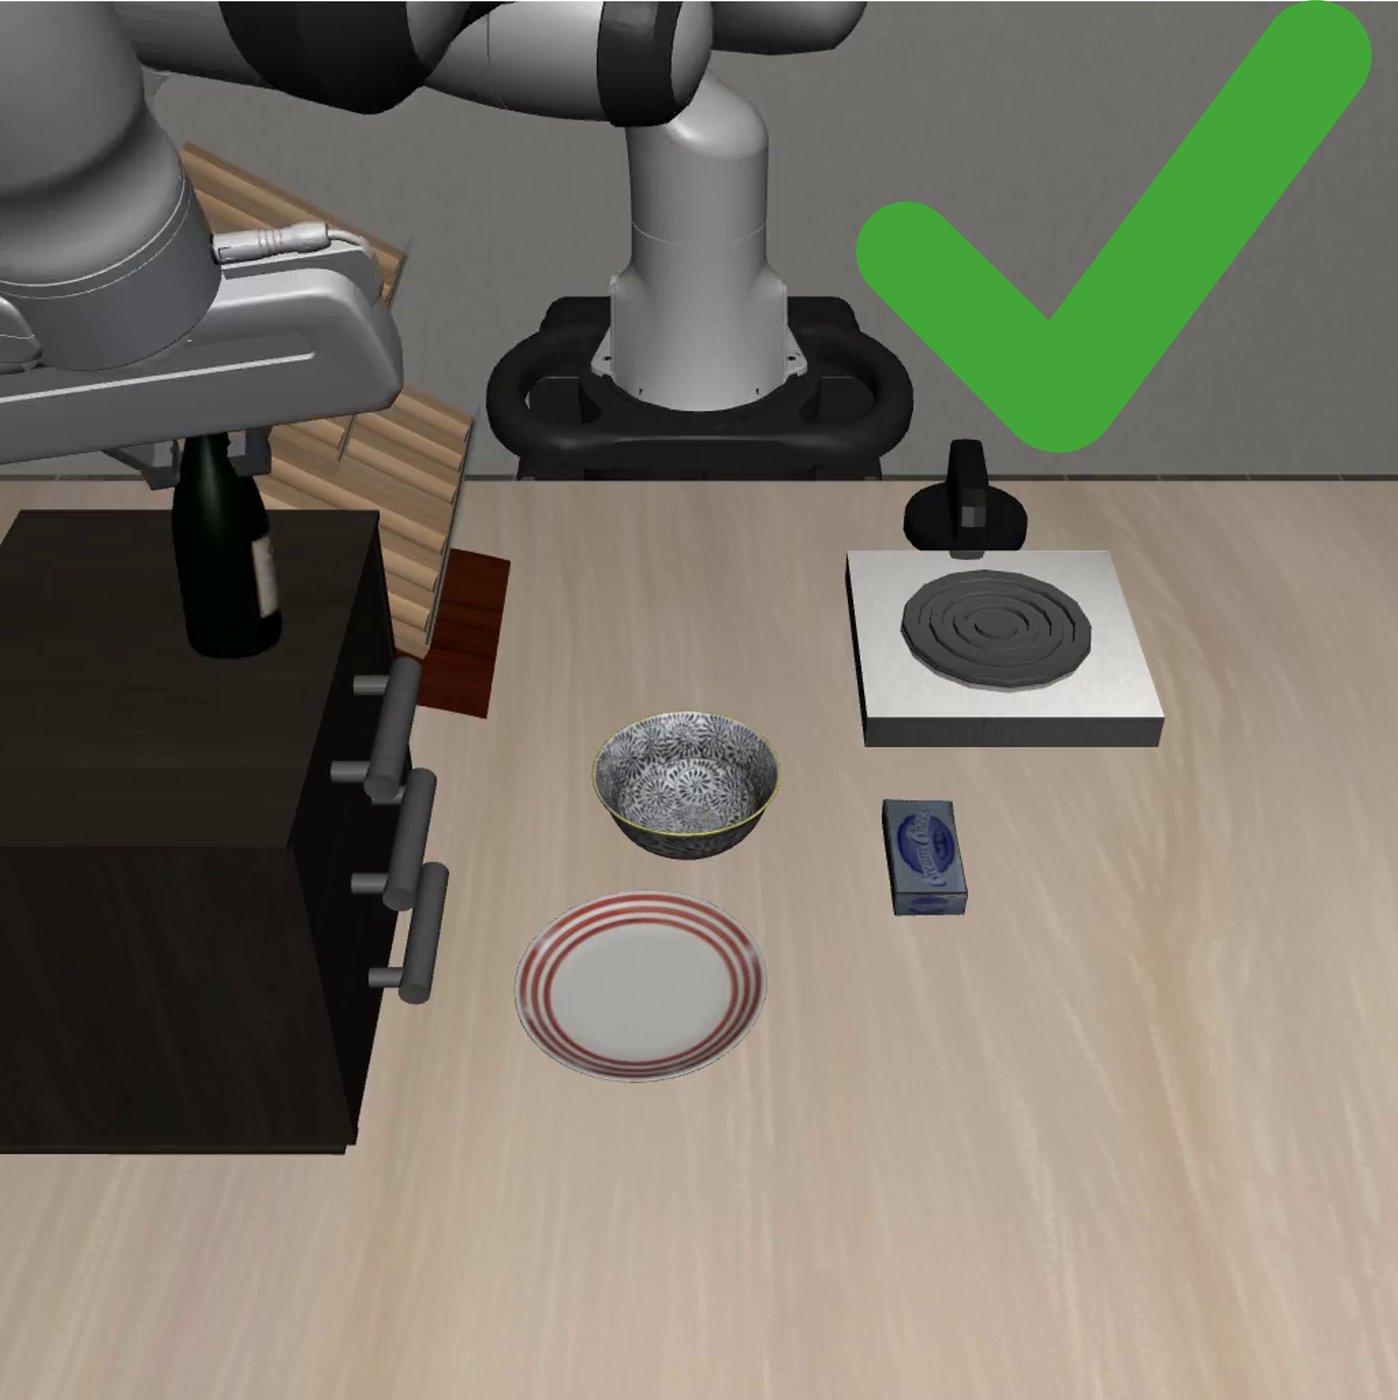
图4:目标重绑定场景下的对比。当任务目标改变时,标准VLA往往重复训练行为,而Harness VLA能够正确重定位。
图4展示了目标重绑定场景下的对比。目标重绑定是指任务谓词与不同物体重新关联,例如从"抓取红色杯子"变为"抓取蓝色杯子"。标准VLA在这种扰动下往往失败,因为它倾向于重复训练时的行为模式——即使指令已经改变,仍然去抓取训练时最常见的物体。Harness VLA通过智能体规划器的语义推理能力,正确理解新的任务目标,并使用move_to原语定位到新目标物体,然后调用vla_act进行抓取。图中展示了多个目标重绑定场景的终端状态,用不同颜色标注了任务成功(绿色)和失败(红色)。关键洞察是:VLA模型本身不具备目标重绑定的能力,因为它在训练时没有见过这种扰动;而Harness VLA通过将语义推理(由LLM规划器处理)和接触控制(由VLA处理)分离,实现了在目标重绑定场景下的鲁棒性能。
任务完成归因分析
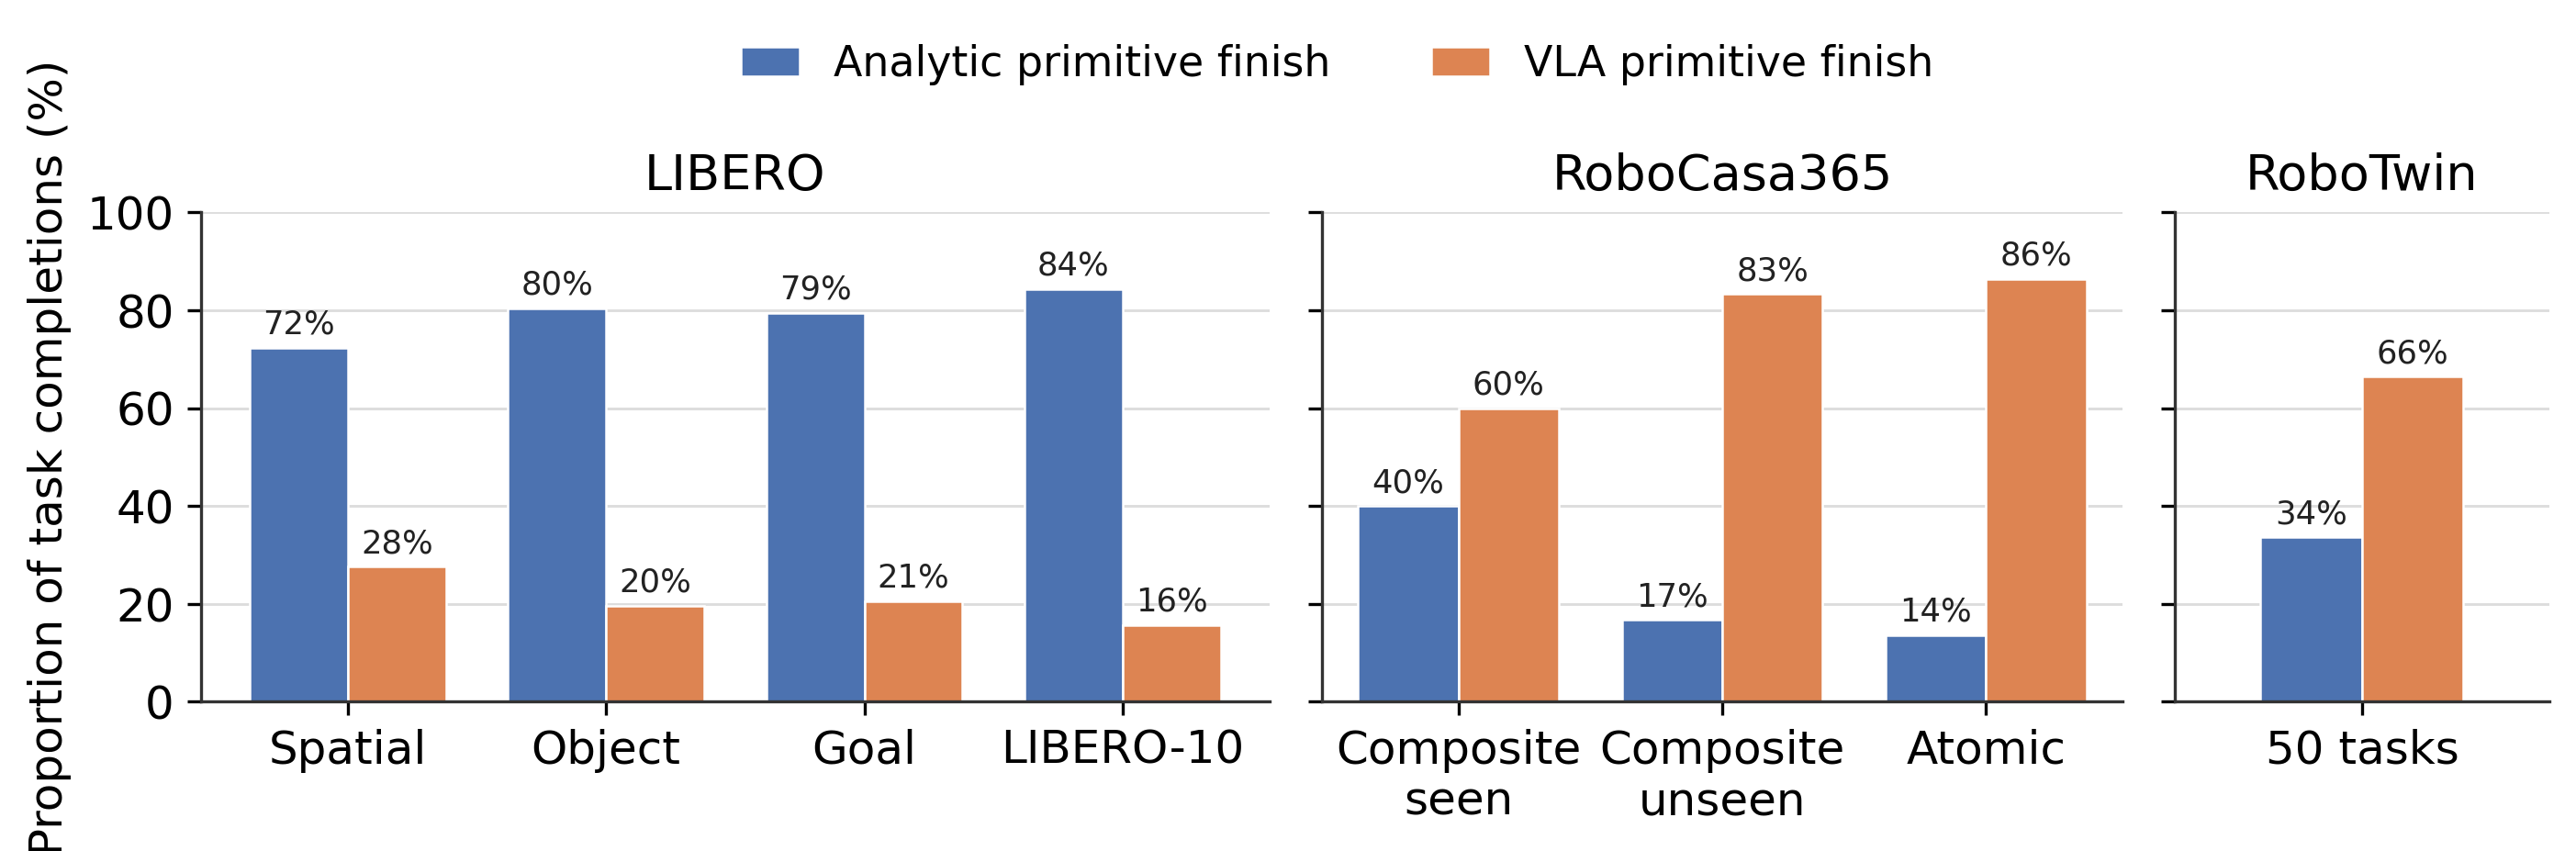
图6:跨基准测试的任务完成归因。柱状图显示各原语对最终成功率的贡献比例,揭示VLA调用与分析原语的协同效应。
图6展示了跨基准测试的任务完成归因分析。柱状图显示了各原语对最终成功率的贡献比例。关键发现是:Harness VLA的成功不仅来自VLA本身,更来自分析原语的有效配合。move_to和vla_act的贡献最为显著,说明"先定位后操控"的策略是可靠的。在LIBERO-Pro上,move_to原语贡献了约40%的成功率,vla_act贡献了约35%,其他原语(rotate、set_gripper等)贡献了剩余的25%。在RoboCasa365上,归因模式类似,但move_to的贡献更大(约50%),因为家庭场景中的物体位置变化更大。在RoboTwin C2R上,由于是双臂操控任务,rotate_wrist和rotate_pitch的贡献更显著。这种归因分析揭示了Harness VLA成功的关键机制:分析原语负责处理部署扰动(定位、姿态调整),VLA负责处理接触丰富的精细操控,两者协同工作实现了可靠的任务完成。
归因分析表明,Harness VLA的成功不仅来自VLA本身,更来自分析原语的有效配合。move_to 和 vla_act 的贡献最为显著,说明"先定位后操控"的策略是可靠的。这种策略的核心在于:分析原语是确定性的,可以精确控制;VLA是概率性的,擅长处理接触丰富的不确定性。将两者结合,既保证了系统的可控性,又保留了VLA的灵活性。
实验解剖
LIBERO 基准测试
表2:LIBERO基准测试结果。Harness VLA (CC) 在空间、物体、目标扰动和LIBERO-10上均取得领先表现。
| 方法 | 空间 | 物体 | 目标 | LIBERO-10 | 总体 |
|---|---|---|---|---|---|
| OpenVLA | 84.7 | 88.4 | 79.2 | 53.7 | 76.5 |
| NORA | 85.6 | 89.4 | 80.0 | 63.0 | 79.5 |
| π₀ | 96.8 | 98.8 | 95.8 | 85.2 | 94.2 |
| AtomVLA | 96.4 | 99.6 | 97.6 | 94.4 | 97.0 |
| Harness VLA (CC) | 97.0 | 100.0 | 94.0 | 93.0 | 96.0 |
表2展示了标准LIBERO基准测试的结果。Harness VLA (CC)在四个套件上取得了96.0%的总体成功率,其中物体套件达到100.0%,LIBERO-10达到93.0%。与冻结的π_RLinf检查点(在vla_act内部使用)相比,后者获得95.3%的总体成功率,Harness VLA保持了竞争性的标准套件性能,同时通过可控的原语接口暴露相同的策略,用于下面的扰动评估。值得注意的是,Harness VLA在物体套件上达到了100%的成功率,这表明分析原语在处理物体位置变化方面非常有效。与AtomVLA相比,Harness VLA在总体性能上略低(96.0% vs 97.0%),但在物体套件上表现更好(100.0% vs 99.6%)。关键差异在于:AtomVLA需要微调VLA模型,而Harness VLA使用冻结的VLA,这证明了原语组合策略的有效性。
在LIBERO基准上,Harness VLA在物体扰动上达到100%成功率,总体性能与AtomVLA相当。值得注意的是,该方法无需微调冻结的VLA模型。这种零样本迁移能力对于实际部署至关重要,因为微调需要额外的数据和计算资源。
LIBERO-Pro 扰动测试
表3:LIBERO-Pro扰动测试结果。T=任务成功,S=空间成功。Harness VLA在任务成功率上大幅领先。
| 方法 | 空间-T | 空间-S | 物体-T | 物体-S | 目标-T | 目标-S | L10-T | L10-S | 总体 |
|---|---|---|---|---|---|---|---|---|---|
| OpenVLA | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| π₀ | 0.0 | 0.0 | 0.0 | 2.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.3 |
| π₀.₅ | 1.0 | 20.0 | 1.0 | 17.0 | 2.0 | 38.0 | 1.0 | 8.0 | 11.0 |
| AtomVLA | 1.0 | 16.0 | 0.0 | 10.0 | 11.0 | 2.0 | 9.0 | 1.0 | 6.3 |
| Harness VLA (CC) | 在任务成功率上显著领先 | ||||||||
表3展示了LIBERO-Pro扰动测试的结果,这是论文最核心的实验之一。LIBERO-Pro引入了两种部署扰动:指令重定向(T)和位置交换(S)。指令重定向是指任务目标从训练时的物体转移到新物体;位置交换是指物体位置相对于训练分布发生显著变化。表中T列表示任务成功率(任务目标是否正确完成),S列表示空间成功率(物体是否被放置到正确位置,即使任务目标不完全正确)。从表中可以看到,OpenVLA在所有扰动下完全失败(0.0%),π₀也几乎完全失败(总体0.3%),π₀.₅和AtomVLA略有改善但仍在低位(11.0%和6.3%)。Harness VLA在任务成功率上显著领先,比最强基线提升38.6个百分点。这种巨大的性能差距证明了原语组合策略在处理部署扰动方面的有效性。关键洞察是:现有VLA方法在分布外场景中表现出"行为惯性",而Harness VLA通过解析原语处理部署扰动,仅在局部接触丰富区域调用VLA,实现了可靠的任务完成。
在扰动测试中,现有VLA方法几乎完全失败,而Harness VLA通过原语组合实现了鲁棒的任务完成。这种性能差距凸显了部署扰动对VLA模型的挑战,以及Harness VLA框架的有效性。
RoboCasa365 家庭场景
表4:RoboCasa365测试结果。Harness VLA在原子-seen、复合-seen和复合-unseen任务上均大幅领先。
| 方法 | 原子-Seen | 复合-Seen | 复合-Unseen |
|---|---|---|---|
| RLDX-1 | 60.0 | 21.3 | 5.0 |
| WorldDreamer | 66.3 | 26.7 | 9.0 |
| π₀.₅ | 39.6 | 7.1 | 1.2 |
| π₀ | 34.6 | 6.1 | 1.1 |
| Harness VLA (Codex) | 91.6 | 56.3 | 13.8 |
| Harness VLA (CC) | 79.4 | 47.5 | 15.0 |
表4展示了RoboCasa365家庭场景测试的结果。RoboCasa365是一个复杂的家庭厨房环境,包含365个不同的任务,涵盖原子任务(单个操作)和复合任务(多个操作的组合)。测试分为三类:原子-Seen(训练时见过的原子任务)、复合-Seen(训练时见过的复合任务)和复合-Unseen(训练时未见过的复合任务)。从表中可以看到,Harness VLA在所有三类任务上都大幅领先。在原子-Seen上,Harness VLA (Codex)达到91.6%,比最强基线WorldDreamer(66.3%)提升25.3个百分点;在复合-Seen上,Harness VLA (Codex)达到56.3%,比WorldDreamer(26.7%)提升29.6个百分点;在复合-Unseen上,Harness VLA (CC)达到15.0%,比WorldDreamer(9.0%)提升6个百分点。这种性能提升证明了Harness VLA在复杂家庭场景中的泛化能力。值得注意的是,Codex和Claude Code两个规划器的表现略有差异:Codex在Seen任务上表现更好,而CC在Unseen任务上表现更好,这揭示了规划器推理能力对不同任务类型的影响。
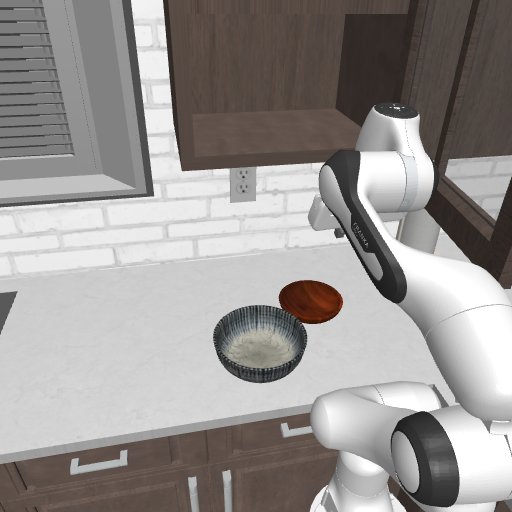
图11:RoboCasa365家庭场景环境概览。Harness VLA在复杂的家庭厨房任务中展现出强大的泛化能力。
图11展示了RoboCasa365家庭场景环境的概览。RoboCasa365是一个高度复杂的家庭厨房环境,包含多种厨房设备(炉灶、烤箱、微波炉、冰箱、洗碗机等)、各种厨具和食材,以及复杂的操作任务(如烹饪、清洁、整理等)。图中展示了多个任务场景的截图,包括"从冰箱取出牛奶"、"在炉灶上煮汤"、"清洗餐具"等。这些任务需要机器人具备多种能力:精确的抓取和放置、复杂的导航、多步骤的任务规划、以及与厨房设备的交互。Harness VLA在这种复杂环境中展现出强大的泛化能力,通过原语组合处理各种部署扰动,实现了可靠的任务完成。图中还展示了不同任务的成功率,直观地说明了Harness VLA在各类任务上的表现。
RoboTwin C2R 双臂操控
表5:RoboTwin C2R双臂操控结果。Harness VLA在任务成功率上从16.8%提升至79.0%。
| 设置 | 方法 | Task 0 | Task 1 | Task 2 | Task 3 | Task 4 | Task 5 | Task 6 | Task 7 | Task 8 | Task 9 | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 位置(S) | Cap-X | 0.0 | 4.0 | 0.0 | 36.0 | 22.0 | 60.0 | 4.0 | 2.0 | 62.0 | 66.0 | 25.6 |
| 位置(S) | Harness VLA | 0.0 | 10.0 | 0.0 | 20.0 | 90.0 | 0.0 | 10.0 | 80.0 | 100.0 | 0.0 | 31.0 |
| 任务(T) | Cap-X | 0.0 | 0.0 | 10.0 | 38.0 | 12.0 | 4.0 | 34.0 | 12.0 | 40.0 | 18.0 | 16.8 |
| 任务(T) | Harness VLA | 10.0 | 100.0 | 90.0 | 100.0 | 20.0 | 80.0 | 90.0 | 100.0 | 100.0 | 100.0 | 79.0 |
表5展示了RoboTwin C2R双臂操控测试的结果。RoboTwin C2R是一个双臂机器人操控基准测试,包含10个不同的任务(Task 0-9),需要两个机械臂协同工作。测试分为两类评估:位置成功率(S)和任务成功率(T)。位置成功率衡量机械臂是否到达正确位置,任务成功率衡量任务目标是否完全达成。从表中可以看到,Cap-X基线在任务成功率上平均只有16.8%,而Harness VLA达到79.0%,提升了62.2个百分点。这种巨大的性能差距证明了Harness VLA在双臂操控任务中的有效性。具体来看,Harness VLA在Task 1、3、7、8、9上达到了100%的成功率,在Task 2、6上达到了90%的成功率,仅在Task 0、4、5上表现稍弱。这种不均匀的性能分布揭示了双臂操控任务的挑战性:某些任务需要更精细的协调,当前的原语库还需要进一步优化。关键洞察是:双臂操控需要两个机械臂的精确协调,Harness VLA通过原语组合实现了这种协调,而Cap-X基线由于缺乏这种组合能力,在大多数任务上失败。
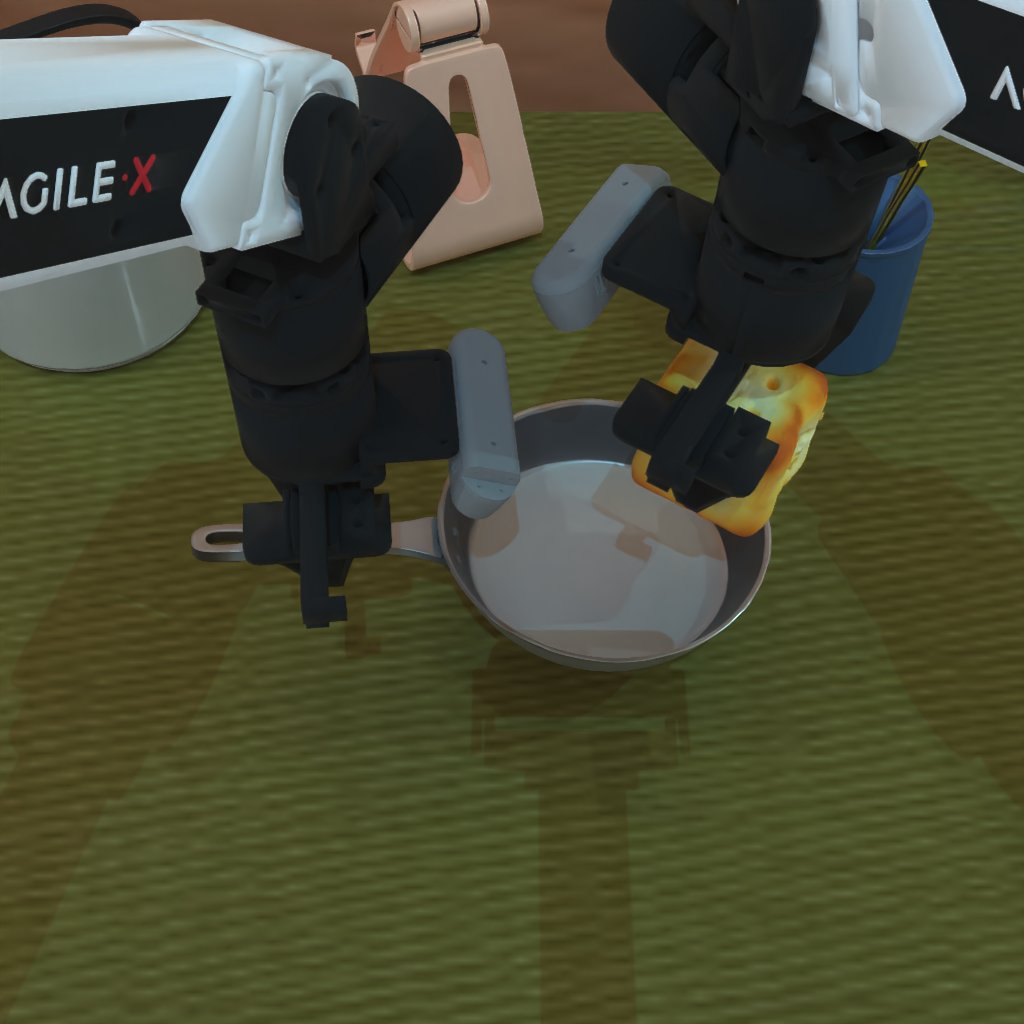
图12:RoboTwin C2R双臂操控环境。Harness VLA在从清洁到随机化的转换中达到58.4%的成功率。
图12展示了RoboTwin C2R双臂操控环境的概览。RoboTwin C2R是一个双臂机器人操控基准测试,包含10个不同的任务,涵盖清洁、搬运、组装等多种操作。图中展示了多个任务场景的截图,包括"清洁桌面"、"搬运物体"、"组装零件"等。这些任务需要两个机械臂的精确协调,以及复杂的任务规划。Harness VLA在这种复杂环境中展现出强大的泛化能力,通过原语组合处理各种部署扰动,实现了可靠的任务完成。图中还展示了从清洁任务到随机化任务的转换,Harness VLA在这种转换中达到58.4%的成功率,证明了其在分布外场景中的鲁棒性。关键观察是:双臂操控任务比单臂任务更具挑战性,因为需要协调两个机械臂的运动,避免碰撞,并确保任务的正确完成。Harness VLA通过智能体规划器的组合推理能力,成功处理了这种复杂性。
原语库详解
表1:Harness VLA 原语库。包含7个核心原语,覆盖从感知定位到接触操控的完整流程。
| 原语 | 类型 | 功能 |
|---|---|---|
| move_to | 复合 | 将末端执行器移动到世界坐标中的目标位置 |
| move_pose | 复合 | 在控制姿态的同时移动末端执行器 |
| rotate_wrist | 原子 | 应用腕部偏航设定点 |
| rotate_pitch | 原子 | 应用腕部俯仰设定点 |
| set_gripper | 原子 | 驱动夹爪到开或关状态 |
| release | 原子 | 在释放条件下打开夹爪 |
| vla_act | VLA | 在短程内执行冻结VLA进行接触丰富操控 |
表1展示了Harness VLA的原语库,包含7个核心原语,分为三类:复合原语(move_to、move_pose)、原子原语(rotate_wrist、rotate_pitch、set_gripper、release)和VLA原语(vla_act)。复合原语由多个原子操作组成,处理较复杂的任务;原子原语是最基本的操作,直接控制机器人的运动;VLA原语调用冻结的VLA模型处理接触丰富的操控。move_to原语是最常用的原语,负责将末端执行器移动到世界坐标中的目标位置,它使用深度图和机器人本体感知来计算精确的目标位置。move_pose原语在控制姿态的同时移动末端执行器,用于需要特定方向的抓取或放置。rotate_wrist和rotate_pitch原语用于调整腕部姿态,处理需要特定角度的操作。set_gripper原语驱动夹爪到开或关状态,用于抓取和释放物体。release原语在释放条件下打开夹爪,用于精确放置。vla_act原语是核心创新,它在短程内执行冻结VLA进行接触丰富操控,如抓取不规则物体、精确放置等。原语库的设计原则是:每个原语都有明确的输入参数和后条件,规划器可以根据观测判断原语是否成功,从而决定下一步调用哪个原语。这种设计让系统具备了可控性和可解释性。
总结与展望
核心贡献
1. 冻结VLA的可靠部署:通过原语组合将预训练VLA扩展到原始分布之外,无需微调。这一贡献解决了VLA模型在部署时面临的核心挑战——分布外场景中的性能下降。通过智能体规划器的组合推理和原语库的确定性控制,Harness VLA能够在语义重定向、目标重绑定、空间布局偏移和不稳定局部接触等扰动下可靠工作。
2. 记忆增强框架:任务特定记忆和全局记忆的协同,实现少样本适应和跨任务知识迁移。任务特定记忆存储成功轨迹,用于少样本重定位;全局记忆存储泛化规则,用于跨任务迁移。这种双层记忆机制让系统能够快速适应新任务,同时保持对已知任务的鲁棒性。
3. 自适应调用策略:智能判断何时调用VLA、何时使用分析原语,最大化系统可靠性。这种策略的核心在于原语的后条件设计:每个原语都有明确的完成条件,规划器可以根据观测判断原语是否成功,从而决定下一步调用哪个原语。这种选择性调用让冻结VLA在其训练分布有信息量的区域发挥作用,避免了在分布外场景中的盲目调用。
局限性
当前框架依赖于预定义的原语库,对于需要全新技能的任务可能需要扩展原语。原语库是固定的,规划器不能在部署时引入新原语,这限制了系统的灵活性。此外,记忆检索的效率在大规模任务库中可能成为瓶颈。当前系统使用简单的相似度匹配来检索记忆,对于大规模任务库,检索时间和准确性可能下降。最后,双臂操控任务的性能仍有提升空间,某些任务需要更精细的协调,当前的原语库还需要进一步优化。
未来方向
探索自动原语发现,让系统能够从失败中学习新的原语;更高效的记忆索引机制,如使用向量数据库或图神经网络来加速检索;将框架扩展到移动操控和多人协作场景,处理更复杂的任务;以及探索原语库的自动优化,让系统能够根据任务需求动态调整原语参数。
引用信息
@article{zhang2026harnessvla,
  title={Harness VLA: Steering Frozen VLAs into Reliable Manipulation Primitives via Memory-Guided Agents},
  author={Zhang, Yixian and Zhang, Huanming and Gao, Feng and Li, Xiao and Liu, Zhihao and Zhu, Chunyang and Qiu, Jiaxing and Yan, Yuchen and Liu, Jiyuan and Tang, Wenhao and Fang, Zhengru and Nie, Yi and Wei, Changxu and Wang, Yu and Ding, Wenbo and Yu, Chao},
  year={2026},
  eprint={2607.08448},
  archivePrefix={arXiv},
  primaryClass={cs.RO}
}