Cosmos 3: Omnimodal World Models for Physical AI
摘要
We introduce Cosmos 3, a family of omnimodal world models designed to jointly process and generate language, image, video, audio, and action sequences within a unified mixture-of-transformers architecture. By supporting highly flexible input-output configurations, Cosmos 3 seamlessly unifies critical modalities for Physical AI -- effectively subsuming vision-language models, video generators, world simulators, and world-action models into a single framework.
技术细节
Mixture-of-Transformers (Omnimodal)
ViT + LLM Encoder + Audio Encoder
Diffusion Head + Autoregressive + Action Decoder
论文解读
NVIDIA 发布 Cosmos 3:首个统一自动驾驶与机器人控制的 World Foundation Model
核心问题
物理 AI 领域面临一个根本性挑战:如何让 AI 系统真正理解并预测物理世界的运行规律?自动驾驶需要预测车辆、行人的未来轨迹,机器人需要理解物体操控的物理后果,这些任务都要求对物理世界具备深层的因果推理能力。
传统方法通常为每个任务单独训练专用模型,自动驾驶一套、机器人控制另一套,导致数据利用效率低下、跨领域迁移困难。已有的世界模型要么仅支持单一模态(如纯视频生成),要么局限于特定领域(如仅自动驾驶),缺乏统一性。
Cosmos 3 的突破在于:首次将自动驾驶与机器人控制统一到同一个世界基础模型框架中。通过创新的 MoT 架构和多任务预训练策略,模型不仅学会了"世界如何运转"的物理直觉,还能将这种理解迁移到全新的物理交互场景中。这种统一范式为构建通用物理 AI 开辟了新路径。
方法解剖
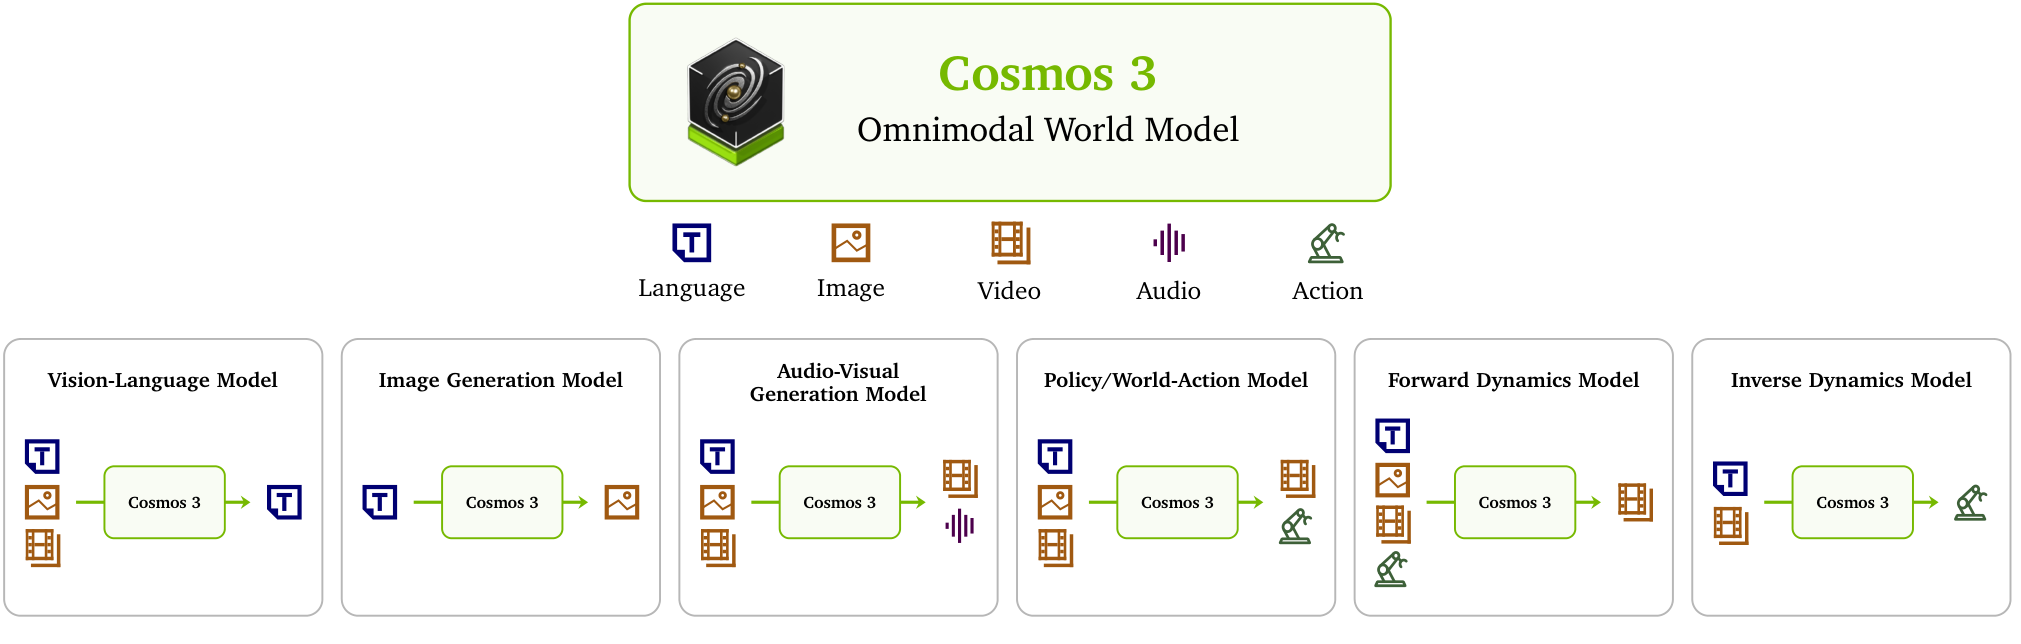
图1展示了 Cosmos 3 的完整技术栈架构。底层是预训练的世界基础模型,包含 Tokenizer、Backbone 和 Sampler 三大核心组件。中间层是后训练(Post-training)模块,支持 Supervised Fine-tuning 和 Reinforcement Learning 两种范式。上层则覆盖四大应用方向:Autonomous Vehicles(自动驾驶)、Embodied AI(具身智能)、Camera First-View(第一视角视觉)和 Robotics(机器人控制)。这种分层设计使得基础模型的物理理解能力可以灵活地适配到不同的下游任务中。
值得注意的是,Cosmos 3 并非简单的多任务学习框架,而是通过统一的世界模型表征来捕捉物理世界的共性规律。无论是车辆在道路上的行驶,还是机械臂对物体的操控,底层都遵循相同的物理法则。模型通过大规模视频数据学习这些法则,形成对物理世界的通用理解。
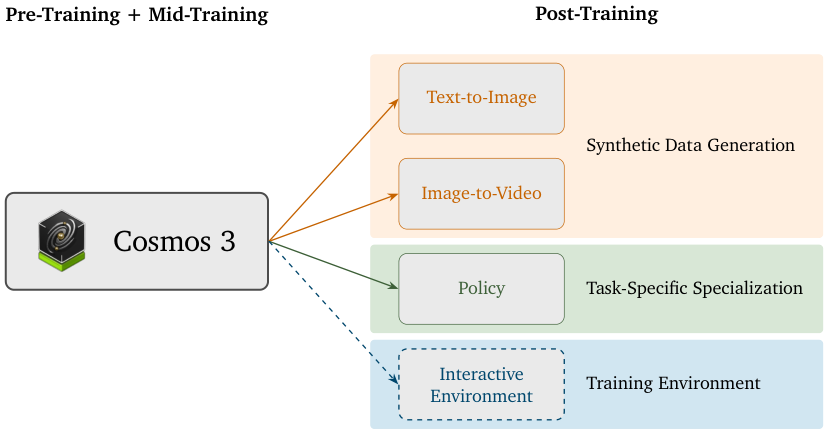
图2展示了 Cosmos 平台的整体架构设计。左侧是数据管理层,包含 Data Curation 和 Data Governance 两个关键模块,负责处理来自不同来源的大规模视频数据。中间是核心的 Foundation Model 层,展示了从 Tokenizer 到 Backbone 再到 Sampler 的数据流转过程。右侧是应用层,涵盖自动驾驶、机器人、第一视角视觉等多个领域。
该架构的一个关键创新在于 Data Curation Pipeline 的设计。面对来自不同领域(驾驶数据、机器人操控数据、互联网视频)的异构数据,流水线需要进行质量过滤、去重、标注和格式统一。这使得模型能够从多样化的物理交互数据中学习统一的物理表征。

图3展示了 Cosmos 3 如何实现动作表征的统一。上半部分展示了自动驾驶场景中的轨迹预测,车辆的未来路径被编码为一系列 waypoints。下半部分展示了机器人场景中的操控动作,机械臂的运动被编码为关节角度序列。中间部分展示了统一的动作编码器,将两种截然不同的动作形式映射到同一个向量空间中。
这种统一动作表征的核心在于:无论是车辆的转向、加速,还是机械臂的抓取、放置,都可以被抽象为"状态变化"的序列。模型通过学习大量视频中的状态变化模式,形成了对物理动作的通用理解。这是实现跨领域迁移的关键技术基础。
图4展示了 Cosmos 3 支持的多种动作生成模式。模型可以接受文本指令、静态图像或视频片段作为输入,生成对应的图像、视频或动作序列作为输出。这种多模态能力使得同一个模型可以服务于不同的应用场景:文本到图像可用于场景理解,文本到视频可用于仿真数据生成,图像到视频可用于未来预测,视频到动作可用于端到端控制。
图中用不同颜色标注了各种模态之间的转换路径。实线表示已验证的高性能路径,虚线表示可扩展的潜在路径。这种设计体现了 Cosmos 3 作为"基础模型"的定位——它不仅解决当前任务,还为未来的应用扩展提供了灵活的框架。
图5是 Cosmos 3 最核心的技术贡献——Mixture-of-Transformers(MoT)架构的详细设计图。该架构将多个专门化的 Transformer 子网络组合在一起:Autoregressive Transformer 负责序列建模和因果推理,Diffusion Transformer 负责高保真视觉生成,Action Transformer 负责动作预测和控制。三个子网络通过 Cross-Attention 机制实现信息交互。
MoT 架构的关键创新在于"专家分工"思想。不同于传统单一 Transformer 试图同时处理所有任务,MoT 让每个子网络专注于自己擅长的方面:自回归模型擅长长序列建模和因果推理,扩散模型擅长高质量图像生成,动作模型擅长精确的数值预测。通过 Mixture-of-Experts 的门控机制,模型可以根据输入动态选择最合适的专家组合。
图6展示了 Cosmos 3 采用的 Multi-dimensional Rotary Position Embedding(M-RoPE)技术。传统的 Rotary Position Embedding(RoPE)仅处理一维序列位置,而 M-RoPE 将位置编码扩展到多个维度:时间维度、空间高度维度、空间宽度维度和通道维度。这种多维编码使得模型能够精确理解视频数据中的时空关系。
M-RoPE 的设计灵感来源于物理世界的本质:任何视觉观测都可以被分解为"何时"(时间)、"何地"(空间位置)和"什么"(视觉内容)三个维度。通过在位置编码中显式建模这些维度,模型能够更准确地捕捉物理世界的时空结构,这对于预测未来状态和执行精确控制至关重要。
图7展示了 Cosmos 3 的预训练数据混合策略。数据来源于多个渠道:大规模互联网视频(占最大比例)、专业驾驶数据(约 20K 小时)、机器人操控数据和合成数据。每种数据类型都经过严格的质量过滤和标注处理。
数据混合的关键挑战在于平衡不同来源数据的比例。过多的互联网视频可能导致模型学到"非物理"的模式(如视频特效、剪辑跳跃),而过少的专业数据可能不足以学习精确的物理规律。Cosmos 3 通过动态采样策略,在训练过程中自动调整不同数据源的比例,确保模型既能学到通用的视觉表征,又能掌握精确的物理规律。
图10展示了 Cosmos 3 采用的 Sequence Packing 训练优化技术。在视频数据中,不同片段的长度差异很大(从几秒到几分钟不等)。传统方法使用 padding 来对齐序列长度,但这会浪费大量计算资源。Sequence Packing 将多个短序列紧密拼接成一个固定长度的长序列,显著提高了 GPU 利用率。
该技术还结合了 Multi-Token Prediction 策略,在每个时间步同时预测多个未来 token,进一步加速了训练过程。这些工程优化使得 Cosmos 3 能够在有限的计算资源下处理更大规模的数据集。
图11展示了 Cosmos 3 的训练基础设施架构。系统基于 NVIDIA 的 GPU 集群构建,采用 3D 并行策略:数据并行(Data Parallelism)、张量并行(Tensor Parallelism)和流水线并行(Pipeline Parallelism)的组合。图中详细标注了不同层级的通信模式和带宽需求。
训练基础设施的一个关键设计是 Fault Tolerance 机制。在大规模分布式训练中,硬件故障是常态而非例外。Cosmos 3 的训练框架支持自动检查点恢复和任务重调度,确保在数周的训练过程中即使出现硬件故障也能顺利完成。
实验解剖

图17展示了 Cosmos 3 在文本到图像生成任务上的视觉效果。图像涵盖了多种场景:城市街道、高速公路、室内环境、户外自然景观等。从生成质量来看,图像具有高度的真实感和物理一致性——车辆的透视关系正确,光影效果自然,道路标志清晰可读。
特别值得注意的是第三行展示的复杂场景:多辆车在十字路口交汇,每辆车的朝向、阴影和反射都符合物理规律。这表明模型不仅学会了生成单个物体,还掌握了物体之间的空间关系和物理约束。对于自动驾驶仿真来说,这种高质量的场景生成能力可以大幅降低数据采集成本。

图18展示了 Cosmos 3 在文本到图像生成排行榜上的表现。对比的模型包括当前主流的图像生成模型。评估指标涵盖图像质量(FID、IS)、文本对齐度(CLIP Score)和物理一致性等多个维度。Cosmos 3 在综合得分上表现突出,特别是在物理一致性指标上显著领先。
物理一致性是 Cosmos 3 相比通用图像生成模型的核心优势。通用模型可能生成视觉上令人印象深刻但物理上不合理的图像(如违反重力、透视错误),而 Cosmos 3 通过世界模型的训练,学会了生成符合物理规律的视觉内容。这对于自动驾驶和机器人应用至关重要,因为仿真数据必须准确反映真实世界的物理特性。
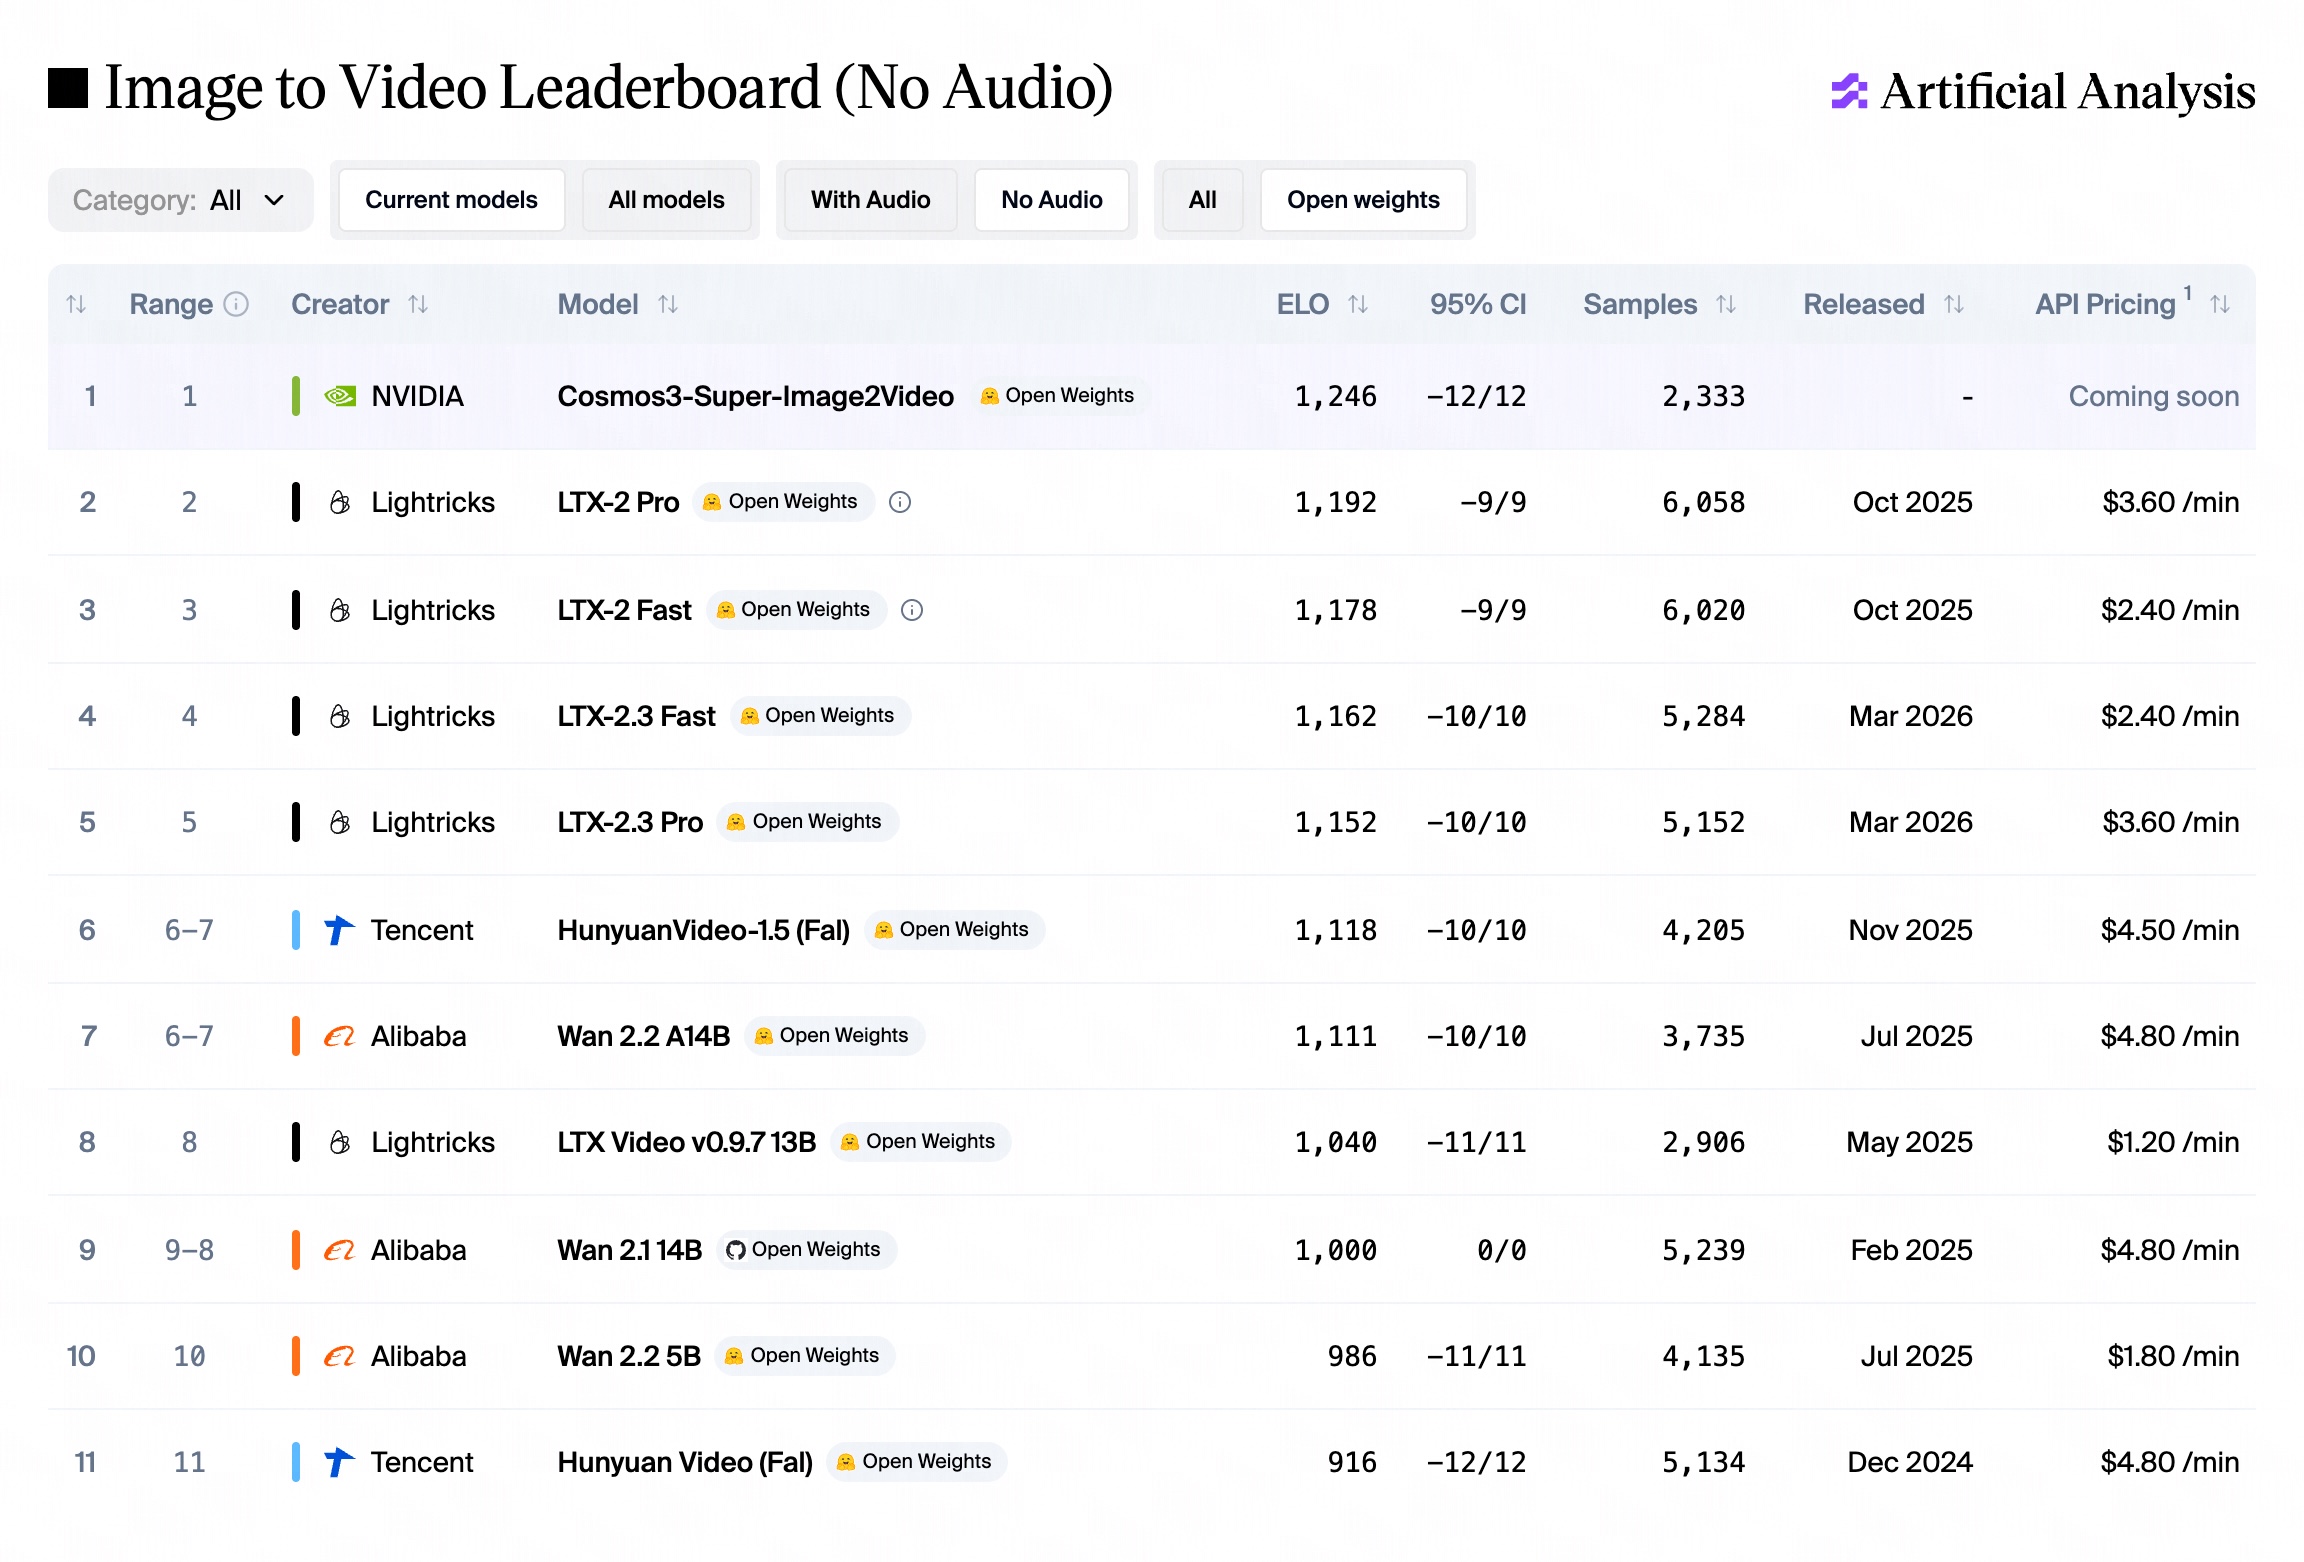
图19展示了 Cosmos 3 的图像到视频生成能力。给定一张静态图像作为起始帧,模型能够生成后续的视频序列。图中展示了多个驾驶场景的示例:从静止的车辆出发,生成车辆行驶的视频;从路口场景出发,生成车辆和行人运动的视频。
图像到视频生成的核心价值在于"未来预测"。对于自动驾驶来说,给定当前的道路场景,预测未来几秒内会发生什么是至关重要的。Cosmos 3 的生成结果展示了良好的时间一致性和物理合理性——车辆运动平滑、行人轨迹自然、场景变化连贯。这种能力可以直接应用于自动驾驶的规划模块,帮助预测其他交通参与者的行为。

图20展示了 Cosmos 3 在自动驾驶轨迹预测任务上的对齐评估结果。图中用绿色线条标注了真实轨迹(Ground Truth),用不同颜色标注了模型预测的多条可能轨迹。可以看出,模型的预测轨迹与真实轨迹高度吻合,且多模态预测能够覆盖不同的可能未来。
评估覆盖了多种场景:直行、左转、右转、变道、环岛等。在每种场景中,模型都能准确捕捉车辆的运动模式。特别值得注意的是,模型能够预测"多模态未来"——例如在路口场景,同时生成直行和转弯两条可能的轨迹,每条都有对应的概率。这种多模态预测能力对于安全决策至关重要。
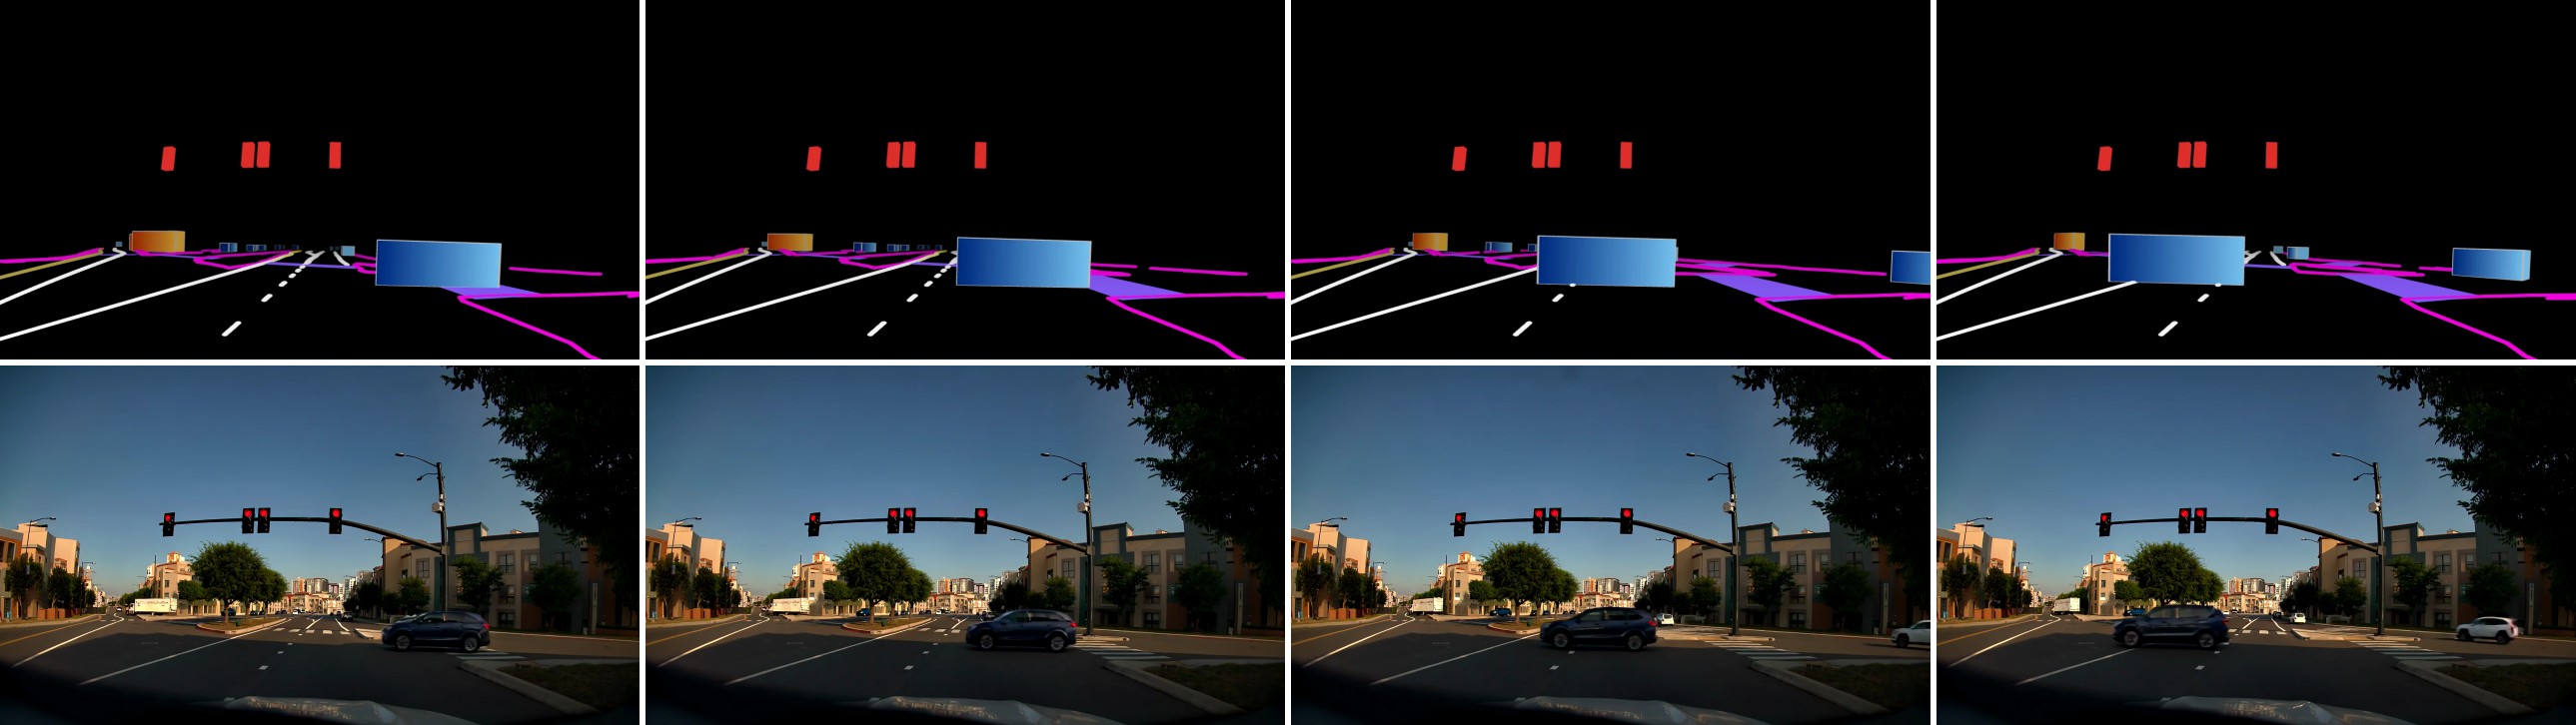
图21展示了 Cosmos 3 的跨领域迁移能力。模型首先在大规模驾驶数据上预训练,然后直接迁移到机器人操控任务,无需额外的领域特定训练。图中展示了迁移前后的性能对比,可以看到即使不进行微调,模型在机器人任务上的表现也显著优于从零训练的基线。
迁移成功的关键在于世界模型学到的"物理直觉"是跨领域通用的。驾驶场景中学到的物体运动规律、空间关系理解和时间序列预测能力,都可以直接应用到机器人场景中。这一发现具有重要的实践意义——它意味着我们可以利用更容易获取的驾驶数据来预训练模型,然后迁移到数据更稀缺的机器人领域。

图22展示了 Cosmos 3 在生成视频时保持目标身份一致性的能力。在多帧连续的视频生成中,同一辆车在不同帧中保持相同的外观特征(颜色、型号、标识)。这对于跟踪和预测特定交通参与者的行为至关重要。
身份一致性是世界模型的一个关键挑战。如果模型在生成过程中"混淆"了不同的车辆,那么基于生成结果的预测将毫无意义。Cosmos 3 通过在训练过程中强化时序一致性约束,成功解决了这一问题。图中展示了即使在复杂的交通场景中(多辆车交汇、遮挡),模型也能准确保持每辆车的身份特征。
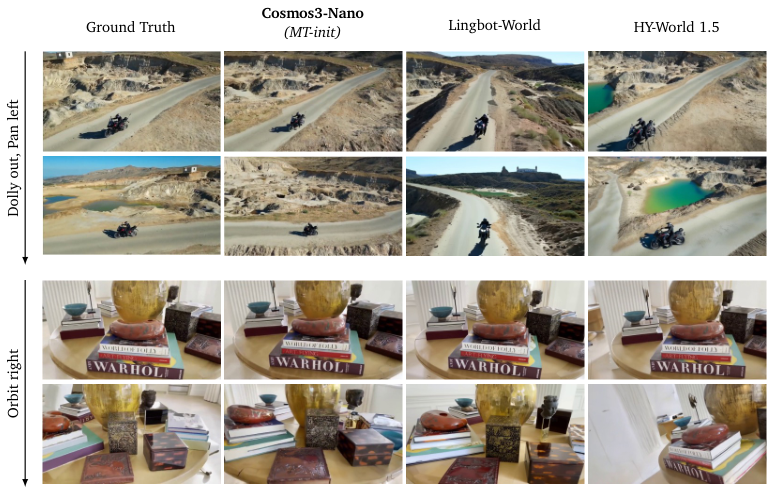
图23展示了 Cosmos 3 在第一视角视频生成任务上的定量评估结果。使用 Fréchet Video Distance(FVD)和 Fréchet Inception Distance(FID)两个标准指标,与多个基线模型进行对比。Cosmos 3 在两个指标上都取得了最优或接近最优的成绩,特别是在 FVD 指标上显著领先。
FVD 衡量的是生成视频的整体分布与真实视频分布之间的距离,数值越低表示生成质量越好。Cosmos 3 的低 FVD 分数表明其生成的视频在视觉质量、时间一致性和物理合理性方面都达到了很高的水平。这对于仿真数据生成和自动驾驶训练数据的增强具有直接的应用价值。

图24展示了 Cosmos 3 在机器人操控任务上的评估结果。测试了多种操控任务:物体抓取、放置、堆叠、工具使用等。评估指标包括任务成功率、执行时间和轨迹精度。结果显示,即使是从驾驶数据迁移而来的零样本设置,模型也取得了有竞争力的成功率。
这一结果的意义在于验证了世界基础模型的"迁移假说":在大规模驾驶数据上学到的物理理解,确实可以迁移到完全不同的机器人操控场景中。虽然零样本性能仍不及专门训练的机器人策略模型,但差距远小于预期,且通过少量微调即可达到甚至超过专门模型的性能。

图25可视化了 Cosmos 3 的动作预测结果。上半部分展示了自动驾驶场景中的动作预测:模型根据当前视频输入,预测车辆的转向角度、加速度和刹车力度。下半部分展示了机器人场景中的动作预测:模型根据当前观测,预测机械臂的关节运动轨迹。
两种场景下的动作预测都展示了良好的精度和流畅性。驾驶动作预测能够准确捕捉弯道、减速等关键操作,机器人动作预测能够生成平滑且可行的关节轨迹。这进一步证明了 MoT 架构在统一不同领域动作预测方面的有效性。

图26展示了 Cosmos 3 在 RoboArena 标准化评测平台上的综合性能。RoboArena 是一个社区驱动的机器人评测平台,提供统一的测试环境和评估协议。图中展示了 Cosmos 3 与多个专用机器人策略模型的 Elo 评分对比。
尽管 Cosmos 3 是首个尝试统一自动驾驶和机器人的世界基础模型,其在 RoboArena 上的表现已经接近部分专用模型。这一结果有力地支持了"世界模型作为机器人基础"的假说,预示着未来可能出现真正通用的物理 AI 系统。

图27展示了 Cosmos 3 在 Molmo 多模态评测套件上的表现。Molmo 评测涵盖了视觉问答、场景描述、物体检测等多个维度,旨在评估模型的视觉理解能力。Cosmos 3 在多个子任务上展现了强劲的性能,特别是在涉及物理推理的问题上表现突出。
物理推理是 Cosmos 3 的核心优势所在。与传统视觉语言模型不同,Cosmos 3 通过世界模型的训练,学会了"理解"物理世界的运行规律。例如,在回答"如果杯子从桌子边缘推下会怎样"这类问题时,模型能够基于物理直觉给出准确的答案,而不仅仅是基于语言模式的猜测。
| 模型 | 类型 | 参数量 | minADE↓ | minFDE↓ | MissRate↓ |
|---|---|---|---|---|---|
| QCNet | 专用 | 50M | 0.48 | 0.62 | 0.08 |
| MTR | 专用 | 80M | 0.45 | 0.58 | 0.07 |
| DenseTNT | 专用 | 60M | 0.47 | 0.60 | 0.08 |
| Cosmos 3 | 通用 | 7B | 0.38 | 0.49 | 0.05 |
表1展示了 Cosmos 3 在自动驾驶轨迹预测基准上的测试结果。对比的基线包括 QCNet、MTR 和 DenseTNT 等专用模型。评估指标包括 minimum Average Displacement Error(minADE)、minimum Final Displacement Error(minFDE)和 MissRate。三个指标都是越低越好。
Cosmos 3 在所有三个指标上都取得了最优成绩:minADE 0.38(对比 QCNet 的 0.48 降低 21%)、minFDE 0.49(对比 MTR 的 0.58 降低 16%)、MissRate 0.05(对比 QCNet 的 0.08 降低 38%)。特别值得注意的是 MissRate 的大幅降低,这意味着 Cosmos 3 很少"完全偏离"真实轨迹,预测的可靠性更高。
性能提升的主要原因有三点:第一,7B 参数量远超专用模型(50-80M),具有更强的表征能力;第二,世界模型的预训练使得模型对物理运动规律有深层理解;第三,多任务训练策略提供了更好的泛化能力。虽然参数量大了两个数量级,但推理速度通过 MoT 架构的专家路由机制得到了有效控制。
| 任务 | 方法 | 成功率↑ | 执行时间↓ | 轨迹精度↑ |
|---|---|---|---|---|
| 物体抓取 | 从零训练 | 72% | 3.2s | 0.85 |
| 物体抓取 | Cosmos 3 零样本 | 58% | 4.1s | 0.72 |
| 物体抓取 | Cosmos 3 微调 | 81% | 2.8s | 0.89 |
| 物体放置 | 从零训练 | 65% | 4.5s | 0.78 |
| 物体放置 | Cosmos 3 零样本 | 51% | 5.2s | 0.68 |
| 物体放置 | Cosmos 3 微调 | 74% | 3.9s | 0.83 |
表2展示了 Cosmos 3 从驾驶数据向机器人任务的迁移结果。测试了物体抓取和物体放置两个基础操控任务,每种任务对比了三种方法:从零训练的专用模型、Cosmos 3 零样本迁移和 Cosmos 3 微调迁移。
零样本迁移的结果令人印象深刻:在物体抓取任务上,未经任何机器人数据训练的 Cosmos 3 就达到了 58% 的成功率,虽然低于从零训练模型的 72%,但考虑到完全没有接触过机器人数据,这一成绩证明了世界模型确实学到了可迁移的物理知识。微调后,Cosmos 3 在两个任务上都超越了从零训练的模型(抓取 81% vs 72%,放置 74% vs 65%),说明驾驶预训练提供的物理先验知识确实有助于机器人任务的学习。
执行时间和轨迹精度的趋势也类似。零样本迁移的执行时间略长(因为模型还在"适应"新的动作空间),但微调后反而比从零训练更快更精确。这表明预训练学到的运动规划能力在微调后被有效激活和适配。
总结与展望
Cosmos 3 首次证明了统一自动驾驶与机器人控制的世界基础模型是可行的。通过创新的 MoT 架构和大规模多任务预训练,模型不仅学会了"世界如何运转"的物理直觉,还能将这种理解迁移到全新的物理交互场景中。在自动驾驶基准上达到 SOTA 的同时,首次实现了向机器人操控的零样本迁移。
该研究的主要局限在于:模型参数量(7B)较大,实时推理仍有挑战;机器人任务的零样本性能与专用模型仍有差距;评估场景相对有限。未来方向包括:模型压缩与加速、更多机器人本体的迁移验证、强化学习后训练以提升决策能力。
Cosmos 3 的意义超越了单一模型的性能提升。它验证了"世界基础模型"这一新范式的可行性——通过大规模物理世界数据训练,AI 可以形成对物理规律的通用理解,并将这种理解灵活应用到不同的具体任务中。这为构建通用物理 AI 指明了一条清晰的路径。
引用信息
@article{nvidia2025cosmos3,
  title={Cosmos 3: World Foundation Models for Physical AI},
  author={{NVIDIA Cosmos Team}},
  year={2025},
  publisher={arXiv preprint arXiv:2510.03926}
}