LDA-1B: Scaling Latent Dynamics Action Model via Universal Embodied Data Ingestion
摘要
当前机器人基础模型主要依赖大规模行为克隆,这种方式模仿专家动作但丢弃了嵌入在异构具身数据中的可转移动力学知识。统一世界模型(UWM)框架有潜力利用这些多样化数据,但现有实例化由于数据使用粗糙和数据集碎片化,难以扩展到基础模型级别。本文提出 LDA-1B,一个通过通用具身数据摄取实现扩展的机器人基础模型。该模型通过联合学习动力学、策略和视觉预测,为不同质量的数据分配不同角色。为支持大规模训练,研究团队组装并标准化了 EI-30K,一个包含超过 30,000 小时人类和机器人轨迹的具身交互数据集。可扩展的动力学学习通过在结构化 DINO 潜在空间中进行预测来实现,避免了冗余的像素空间外观建模。LDA-1B 采用多模态扩散 Transformer 处理异步的视觉和动作流,实现了 10 亿参数规模的稳定训练。实验表明,LDA-1B 在接触丰富、灵巧操作和长期任务上分别超越 π0.5 达 21%、48% 和 23%。
技术细节
MM-DiT
DINO
MM-DiT (Multimodal Diffusion Transformer)
论文解读
LDA-1B:首个通过通用具身数据摄取实现10亿参数扩展的机器人基础模型
当前机器人基础模型主要依赖大规模行为克隆,这种方式模仿专家动作但丢弃了嵌入在异构具身数据中的可转移动力学知识。统一世界模型(UWM)框架有潜力利用这些多样化数据,但现有实例化由于数据使用粗糙和数据集碎片化,难以扩展到基础模型级别。
本文提出 LDA-1B,一个通过通用具身数据摄取实现扩展的机器人基础模型。该模型通过联合学习动力学、策略和视觉预测,为不同质量的数据分配不同角色。为支持大规模训练,研究团队组装并标准化了 EI-30K,一个包含超过 30,000 小时人类和机器人轨迹的具身交互数据集。可扩展的动力学学习通过在结构化 DINO 潜在空间中进行预测来实现,避免了冗余的像素空间外观建模。LDA-1B 采用多模态扩散 Transformer 处理异步的视觉和动作流,实现了 10 亿参数规模的稳定训练。
实验表明,LDA-1B 在接触丰富、灵巧操作和长期任务上分别超越 π0.5 达 21%、48% 和 23%。值得注意的是,LDA-1B 实现了数据高效微调,通过利用通常有害并被丢弃的 30% 低质量轨迹获得了 10% 的性能提升。
核心问题
当前机器人基础模型面临三大核心挑战:
2. 统一世界模型扩展困难:统一世界模型(UWM)框架虽然能联合优化动力学、策略和视频生成,但现有实例化存在数据使用粗糙(不区分数据质量和监督角色)和数据集碎片化(缺乏统一格式和对齐的动作表示)的问题。
3. 像素空间建模冗余:UWM 在像素空间表示未来状态,将动力学学习与冗余的外观建模纠缠在一起。光照、纹理、背景杂乱或相机视角的微小变化会主导训练目标,使大规模训练效率低下,阻碍交互相关动力学的学习。
LDA-1B 通过通用具身数据摄取、结构化潜在空间表示和多模态扩散 Transformer 架构,系统性地解决了这些问题。
方法解剖
统一世界模型框架
LDA-1B 基于统一世界模型(UWM)框架,给定当前观测 ot(通常是 RGB 图像),联合建模多个条件分布:
UWM 通过联合扩散模型同时预测动作和观测的噪声,实现策略、动力学和视觉预测的统一学习。
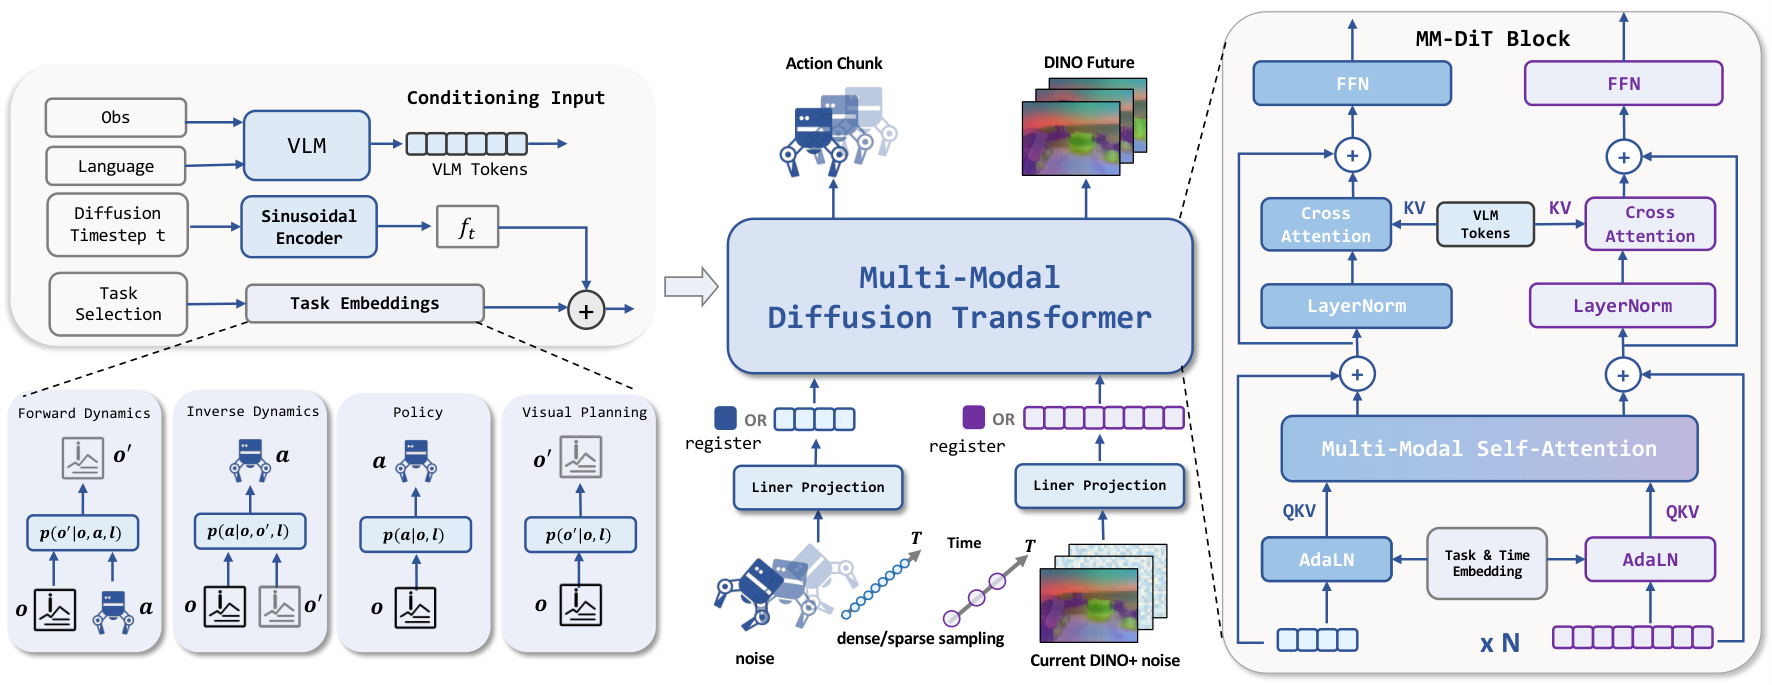
图1展示了 LDA-1B 的整体框架。该模型采用多任务协同训练策略,将异构具身数据按质量分级利用:高质量机器人和人类演示用于所有目标(策略+动力学),低质量轨迹仅用于动力学和视觉预测,大规模无动作标注的人类视频用于视觉预测目标。这种角色感知的数据使用方式防止了对专家行为的过拟合,实现了可转移动力学和动作表示的可扩展学习。
通用数据摄取机制

图2展示了 LDA-1B 的统一末端执行器表示方法。为了在大规模异构数据上实现可扩展的动力学学习,研究团队设计了统一的动作表示框架,将不同机器人本体的动作空间对齐。这使得来自不同平台、不同质量的数据能够在统一格式下进行融合训练。

图3展示了 EI-30K 数据集的构成。这是研究团队组装并标准化的大规模具身交互数据集,包含超过 30,000 小时的人类和机器人轨迹,涵盖真实和模拟环境。数据集采用统一格式标准化,动作表示对齐,为大规模异构数据训练提供了基础。
结构化潜在空间表示

图6对比了 DINO 潜在空间和像素空间的表示差异。传统 UWM 在像素空间表示未来状态,将动力学学习与冗余的外观建模纠缠在一起。LDA-1B 采用结构化 DINO 潜在空间,通过语义化的特征表示,避免了光照、纹理、背景等无关因素的干扰,使动力学学习更加聚焦于交互相关的物理知识。
多模态扩散 Transformer 架构

图8展示了 MM-DiT 的详细架构。为补充 DINO 潜在表示,LDA-1B 采用多模态扩散 Transformer 处理异步的视觉和动作流。该架构引入四个可学习任务嵌入和两个可学习寄存器标记,分别对应策略、前向动力学、逆向动力学和视觉预测四个训练目标。当某个任务中某种模态缺失时,寄存器标记作为占位符,使模型能够灵活处理不同数据源的不同监督信号。

图7展示了 LDA-1B 的扩展性分析结果。实验表明,从 0.5B 扩展到 1B 参数带来了 4.7% 的性能提升,验证了模型的良好扩展特性。移除 MM-DiT 架构会导致 6.5% 的性能下降,证实了多专家设计的有效性。
实验解剖
与现有方法对比
| 模型 | 数据来源 | 数据量 | 动作质量 | 训练方式 | 参数量 |
|---|---|---|---|---|---|
| π0.5 | Tele. | 10k+ | 高质量 | BC | 3B |
| RDT | Tele. | <10k | 高质量 | BC | 1B |
| GraspVLA | Sim. | 20k+ | 高质量 | BC | 2B |
| InternVLA-M1 | Sim. | <10k | 高质量 | BC | 3B |
| Being-H0 | Hum. | <10k | 混合 | Aln.+BC | 14B |
| InternVLA-A1 | Het. | 10k+ | 高质量 | VF+BC | 3B |
| GR00T-N1.6 | Het. | <10k | 混合 | LA+BC | 1B |
| UniVLA | Het. | <10k | 混合 | LA+BC | 7B |
| LDA-1B | Het. | 30k+ | 混合 | UWM | 1B |
表1对比了现有机器人基础模型。LDA-1B 的独特之处在于:(1) 使用异构数据源,包括遥操作、模拟和人类视频;(2) 数据量最大(30k+ 小时);(3) 支持混合质量动作数据;(4) 采用 UWM 训练范式,联合学习动力学、策略和视觉预测。相比之下,现有方法大多仅使用高质量遥操作数据,数据量有限,且采用行为克隆训练方式。
RoboCasa-GR1 基准测试
| 模型 | 视觉表示 | MMDiT | VLM | 成功率 ↑ |
|---|---|---|---|---|
| GR00T-N1.6 | - | - | Cosmos | 47.6 |
| StarVLA | - | - | Qwen3vl | 47.8 |
| GR00T-EI30k | - | - | Qwen3vl | 51.3 |
| UWM-0.1B | VAE | ✗ | - | 14.2 |
| UWM-1B | VAE | ✗ | Qwen3vl | 19.3 |
| UWM(MM-DiT) | VAE | ✓ | Qwen3vl | 20.0 |
| LDA(DiT) | DINO | ✗ | Qwen3vl | 48.9 |
| LDA-0.5B | DINO | ✓ | Qwen3vl | 50.7 |
| LDA-1B | DINO | ✓ | Qwen3vl | 55.4 |
表2展示了 RoboCasa-GR1 基准测试结果。关键发现:(1) 将像素空间 VAE 潜在表示替换为 DINO 表示带来显著性能提升(20.0% → 55.4%),验证了结构化潜在空间对有效扩展的重要性;(2) 移除 MM-DiT 架构导致 6.5% 性能下降(LDA-1B vs LDA(DiT));(3) 从 0.5B 缩减到 1B 参数导致 4.7% 性能下降,证实了模型的良好扩展特性。LDA-1B 以 1B 参数超越了 3B 甚至 14B 的现有方法。
真实世界实验

图10展示了真实世界实验设置。为验证 LDA-1B 的可扩展性和鲁棒性,研究团队在真实世界进行了广泛实验,重点关注对新本体的少样本适应、灵巧操作和混合质量监督下的数据效率。

图11展示了真实世界任务的概览。实验涵盖三类任务:(1) 接触丰富操作,如擦拭、插入等需要精确力控制的任务;(2) 灵巧操作,如使用工具、开门等需要高自由度手部协调的任务;(3) 长期任务,如整理桌面、准备食物等需要多步骤规划的任务。LDA-1B 在所有任务类别上都显著超越 π0.5。

图12展示了灵巧操作演示。LDA-1B 能够控制高自由度灵巧手执行复杂操作,如使用工具、旋转物体等。这得益于模型通过动力学学习获得的精确力控制能力和手指协调能力。
泛化能力分析
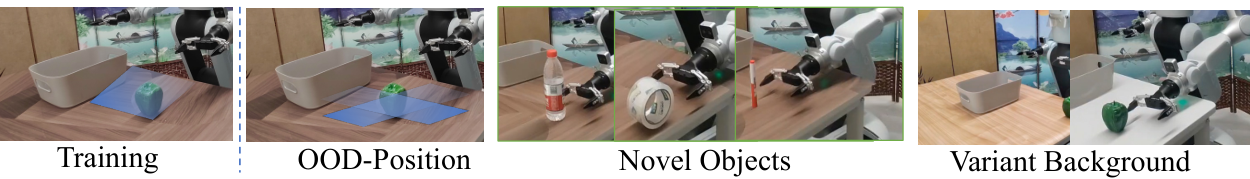
图5展示了泛化能力分析结果。LDA-1B 在多种分布外场景下展现出强大的泛化能力:物体变化时成功率从 π0.5 的 26.7% 提升到 60.0%;背景变化时从 20.0% 提升到 60.0%;新位置场景下从 6.7% 提升到 40.0%。这种泛化能力源于模型通过动力学学习获得的对物理交互本质的理解。

图9展示了 RoboCasa 基准测试场景。该基准包含多种家庭和服务机器人任务,涵盖厨房、客厅、浴室等环境,用于全面评估模型在复杂环境中的表现。LDA-1B 在该基准上取得了 55.4% 的成功率,显著超越现有方法。

图4展示了实验结果画廊。图片呈现了 LDA-1B 在多种任务上的成功执行案例,直观展示了模型在不同任务类型和场景下的表现。
数据效率分析
| 方法 | Pick & Place | Object | Background | OOD Pos. |
|---|---|---|---|---|
| π0.5 | 26.7 | 20.0 | 6.7 | |
| GR00T | 40.0 | 40.0 | 20.0 | |
| LDA-1B | 60.0 | 60.0 | 40.0 |
表3展示了数据效率微调结果。LDA-1B 的一个关键优势是能够利用通常有害并被丢弃的低质量轨迹。实验表明,通过利用 30% 的低质量轨迹进行微调,模型获得了额外的 10% 性能提升。这是因为 LDA-1B 的动力学学习框架能够从低质量数据中提取有价值的物理交互知识,而不会受到次优动作的负面影响。
总结与展望
主要贡献
1. 通用具身数据摄取框架:提出角色感知的数据使用策略,为不同质量的数据分配不同角色,最大化数据利用率。
2. EI-30K 数据集:组装并标准化了包含超过 30,000 小时人类和机器人轨迹的大规模具身交互数据集。
3. 结构化潜在空间表示:采用 DINO 潜在空间避免冗余外观建模,实现高效动力学学习。
4. MM-DiT 架构:设计多模态扩散 Transformer 处理异步视觉和动作流,实现 10 亿参数规模稳定训练。
5. 卓越性能:在接触丰富、灵巧操作和长期任务上分别超越 π0.5 达 21%、48% 和 23%。
局限性
1. 依赖固定的 DINO 视觉特征,可能限制对新视觉视角的泛化。
2. 主要使用自我中心相机视角,多模态信号的泛化能力有待验证。
未来方向
1. 联合学习视觉表示和潜在动力学。
2. 扩展到更丰富的感官模态(触觉、力觉等)。
3. 自动优化数据角色分配。
4. 推动可扩展、异构数据驱动的机器人基础模型的社区应用。
引用信息
@article{liu2025lda1b,
  title={LDA-1B: Scaling Latent Dynamics Action Model via Universal Embodied Data Ingestion},
  author={Liu, Yuxuan and Zhu, Yifeng and Wu, Yilin and others},
  journal={arXiv preprint arXiv:2602.12215},
  year={2025}
}
本报告中的图片和内容来源于原论文,仅供学术研究参考。

